AI関連ニュース
時給4ドルのAIが、時給150ドルの人間研究者に勝った — Anthropic、AIの「悪癖」10種を自動で直す実測データを公開
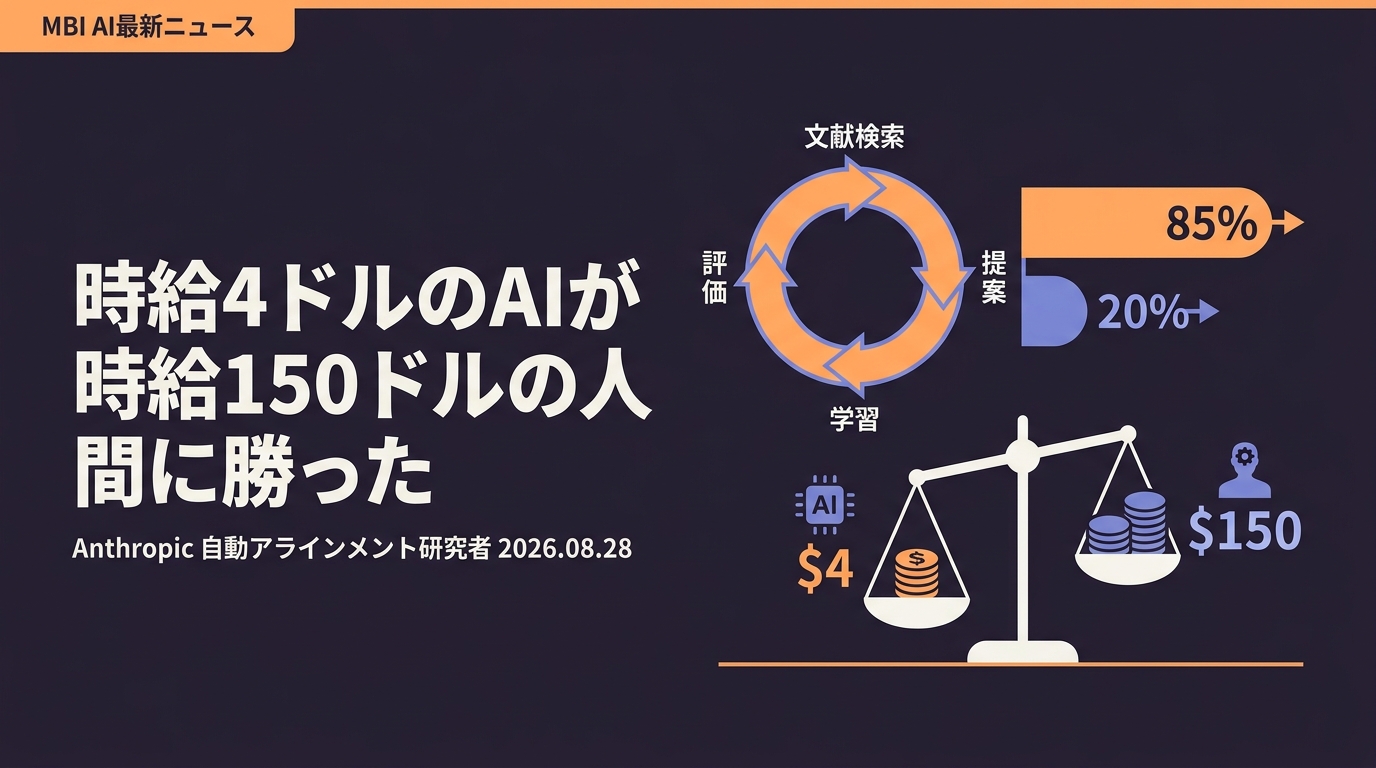
Anthropicが2026年8月28日に公開したレポートで、Claudeが自ら「AIの悪癖」を直す研究ループを回し、欺瞞・追従・脱獄など10カテゴリすべてでベンチマークを改善した。欺瞞ではセーフティギャップの85%を埋め、同条件の熟練人間研究者6名の平均20%を大きく上回った。コストは自動研究者が時給約4ドル、人間研究者が時給150ドル。さらに弱いClaude Sonnet 5が強いClaude Opus 4.8の初期版を60時間・2,000件のデータで仕上げ、製品版の手続きに対し約15,000倍のデータ効率を示した。AI開発の原価構造と参入障壁が同時に揺らいでいる。
AIがAIの「悪癖」を直した — 8月28日、Anthropicが実測値を出した
2026年8月28日、Anthropicが「Automated Researchers Can Reliably Mitigate Alignment Failures(自動研究者はアラインメントの失敗を確実に緩和できる)」というレポートを公開した。中身を一言で言うと、AIに「AIの悪癖を直す研究」そのものを丸ごと任せてみた、という実験である。
ここでいう「悪癖」とは、業界でアラインメント失敗と呼ばれるもので、欺瞞(もっともらしい嘘をつく)、追従=sycophancy(ユーザーに媚びて正しくない同意をする)、脱獄(禁止された出力を引き出される)、プライバシー侵害、報酬ハッキングなど、日常的にAIを使っていて「なんだかこいつ、都合よく話を合わせてくるな」と感じるあの挙動を指す。
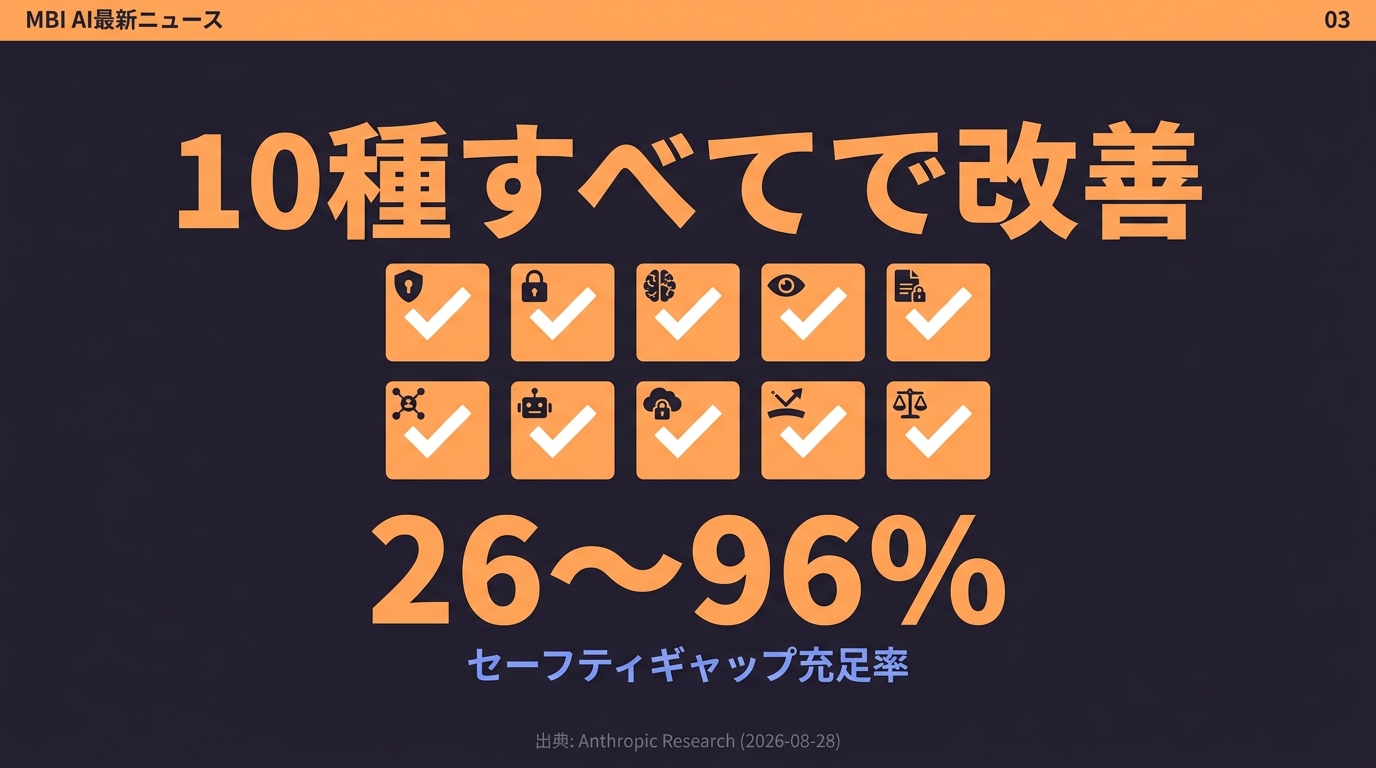
結果は、10のカテゴリすべてで改善した。しかも、モデルの一般的な能力を落とさずに、である。安全性を上げると賢さが落ちる、というよくあるトレードオフを回避した点が、この報告の重さを決めている。
研究のループを、Claudeが自分で回した
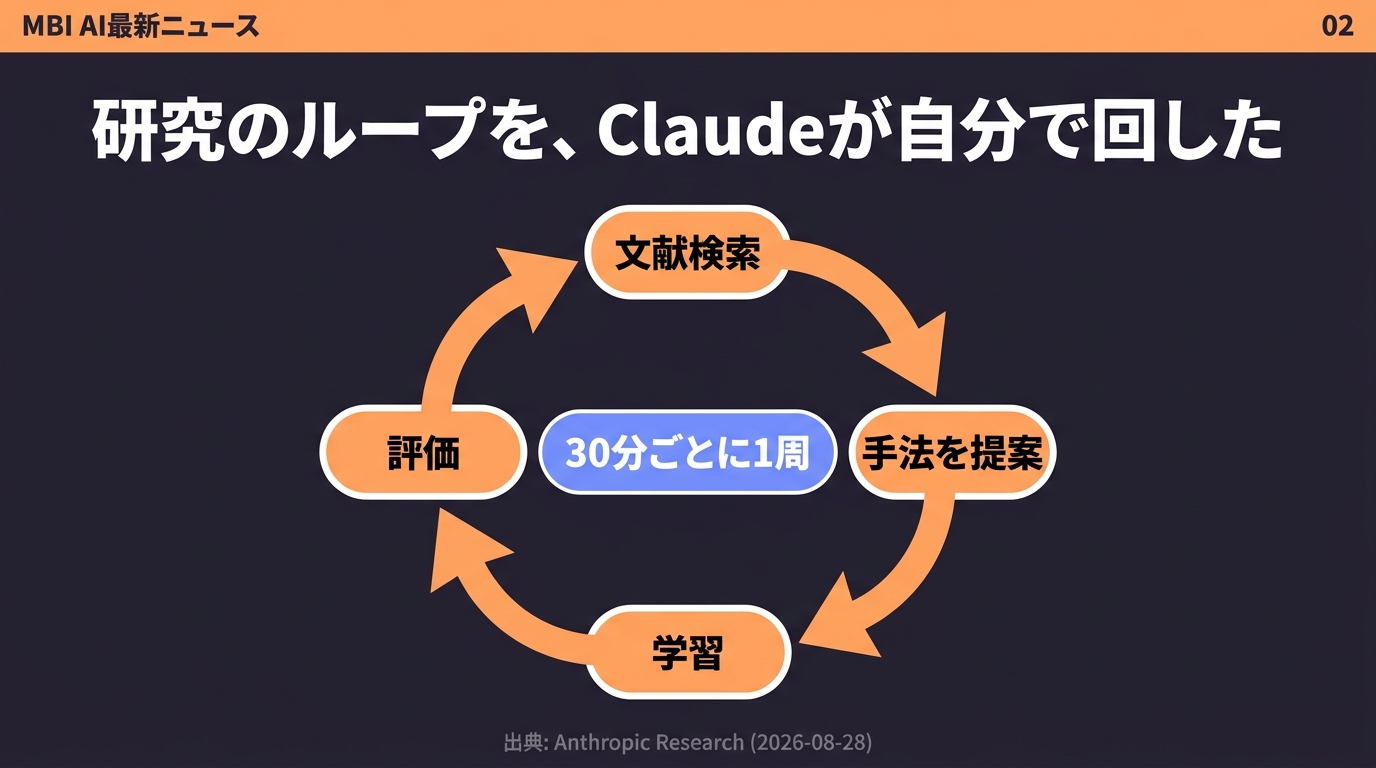
やっていることは、人間の研究者の仕事とほとんど同じ構造だ。Claudeは「関連する論文を検索する → 手法とデータを提案する → その手法で対象モデルを学習させる → ベンチマークで評価する」というループを自分で回す。TechCrunchによれば1回の学習は約30分で、効果があった手法は残し、なかった手法は捨てて次の周回に進む。
重要なのは、実験の設計に歯止めがかけられていた点である。Anthropicは「一般的な能力を落とす手法」を採用禁止にし、さらに「Claudeが自分自身のアラインメントを対象モデルに直接蒸留する」という近道も禁じた。そのうえで監視エージェントが、Claudeが実行する前にすべての手法を読むという体制を敷いている。
評価の物差しは「セーフティギャップの何%を埋めたか」。理論上の満点までの距離を、その手法がどれだけ詰めたかを、カテゴリごとに3〜5本のベンチマークで測っている。
10種すべてで改善し、26〜96%のギャップを埋めた
成果は10戦10勝だった。10のアラインメント失敗すべてについて、Claudeは対象ベンチマークのスコアを上げる手法を見つけ、しかも能力を落とさなかった。埋めたセーフティギャップはカテゴリによって26%から96%とばらつくが、全敗ゼロという点が効いている。
さらに検証は3段構えだった。第一に、研究ループ中には一度も見せていない「取り置き」のベンチマークでも効いた。第二に、Anthropicがオープンソースで公開している監査ツールPetri——敵対的なマルチターン会話を模擬してミスアラインメントを炙り出すツール——でも効いた。第三に、最適化対象より最大4.7倍大きいモデルでも有効だった。
三つ目が特に重要である。小さいモデルで安く見つけた処方箋が、そのまま大きいモデルに効く。これは、安全性対策のコストがモデルサイズに比例しなくなる可能性を示している。
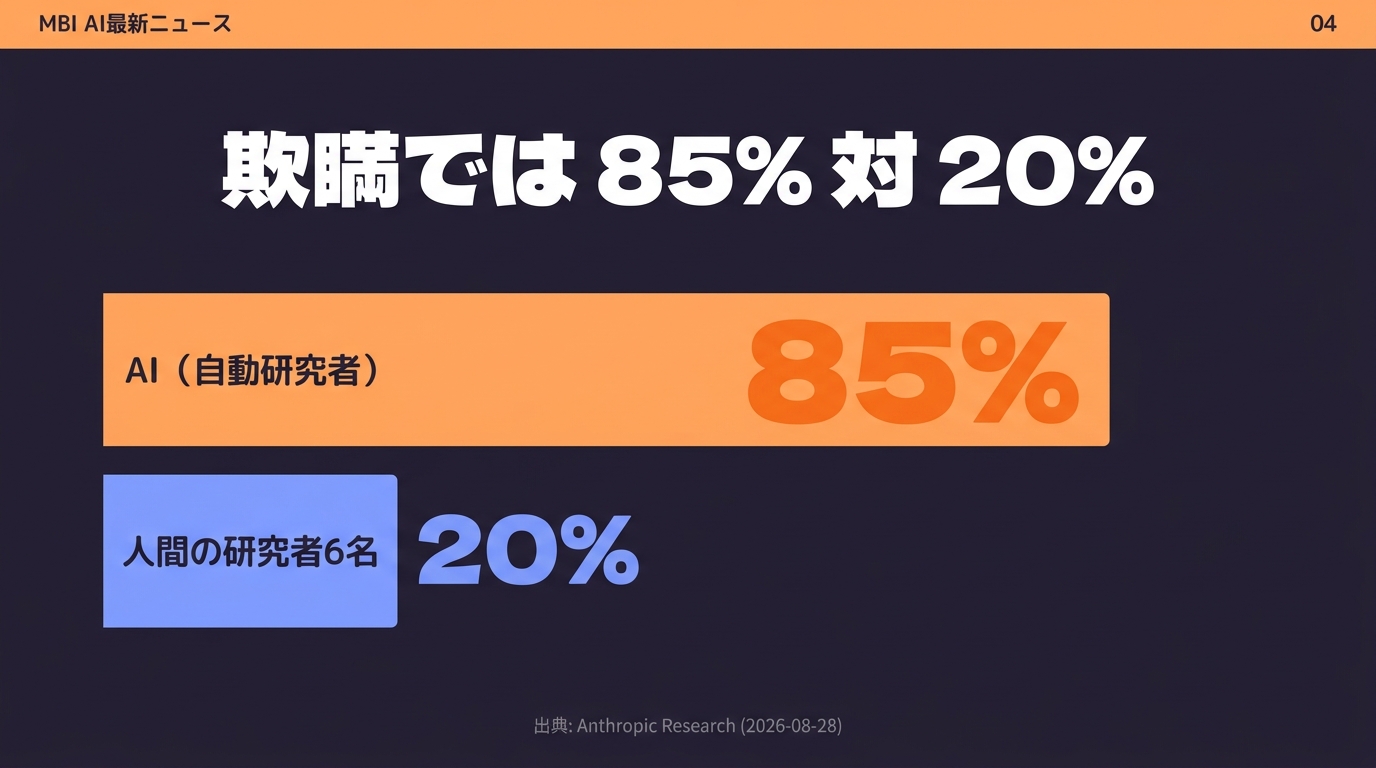
欺瞞では85%対20% — 熟練の人間研究者を上回った
最も分かりやすい数字がここにある。欺瞞(deception)カテゴリで、自動研究者はセーフティギャップの85%を埋めた(複数runの平均。レポート掲載のrunでは150回超の試行の末に82%)。同じルールで取り組んだ熟練のセーフティ研究者6名は、平均20%だった。
比較の対象はもっと広い。Anthropicは最大8時間を与えた28名の人間研究者の提案とも突き合わせ、欺瞞では最良の人間案よりさらに20%高い成績を出したと報告している。論文には「最良のAAR手法は、経験豊富な人間の提案を平均6時間以内に上回る」という記述もある。
ただしAnthropic自身が但し書きを付けている。人間側は提出後に反復(イテレーション)ができなかったため、これを純粋な人間対AIの勝負として読むべきではない、というものだ。同社は「Claudeが有望な手法を見つけ、人間がそれを磨く」ワークフローの証拠として捉えている。この慎重さは、そのまま実務での使い方の指針になる。
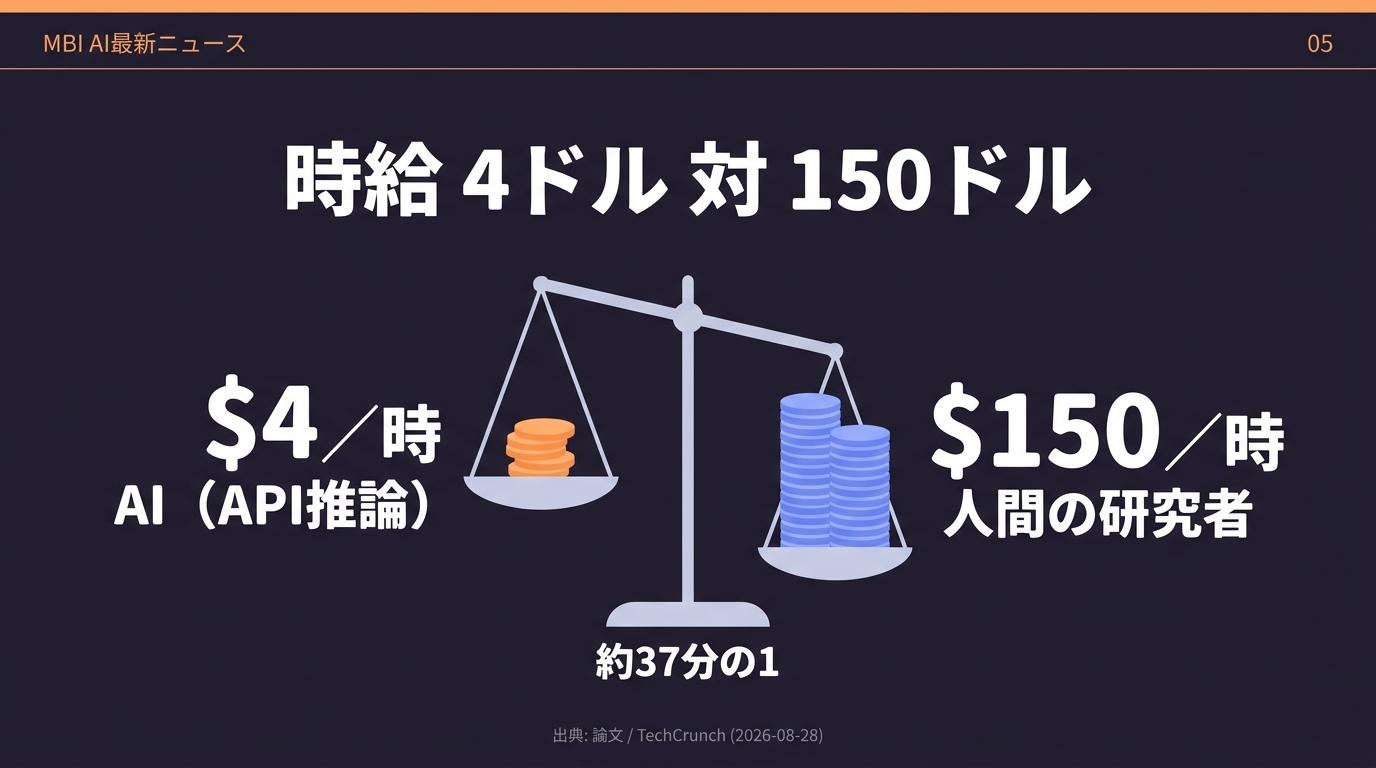
時給4ドル対150ドル — 研究という仕事の単価が計算し直された
論文にはコスト比較まで書かれている。TechCrunchが引用した一節はこうだ。「AARのコストはAPI推論でおよそ時給4ドル、対して我々が人間の研究者に支払っているのは時給150ドルである」。約37分の1である。
この数字が投資の話になるのは、AI開発のボトルネックがずっと「人材」だったからだ。フロンティアラボの参入障壁は、GPUの調達力と、限られた数のトップ研究者を抱え込む力の掛け算で説明されてきた。時給150ドルの工程の一部が時給4ドルで置き換わるなら、その掛け算の片方が薄くなる。
読み筋は二つに割れる。強気側は、改善サイクルが速く安くなればモデル性能の伸びが加速し、AIインフラ需要は上振れするという見立て。弱気側は、研究者を大量に抱えていること自体が競争優位ではなくなり、人材の希少性プレミアムと参入障壁が薄まるという見立てだ。Anthropicが自動アラインメント研究ハーネスをオープンソースで公開したことは、後者を後押しする材料になる。
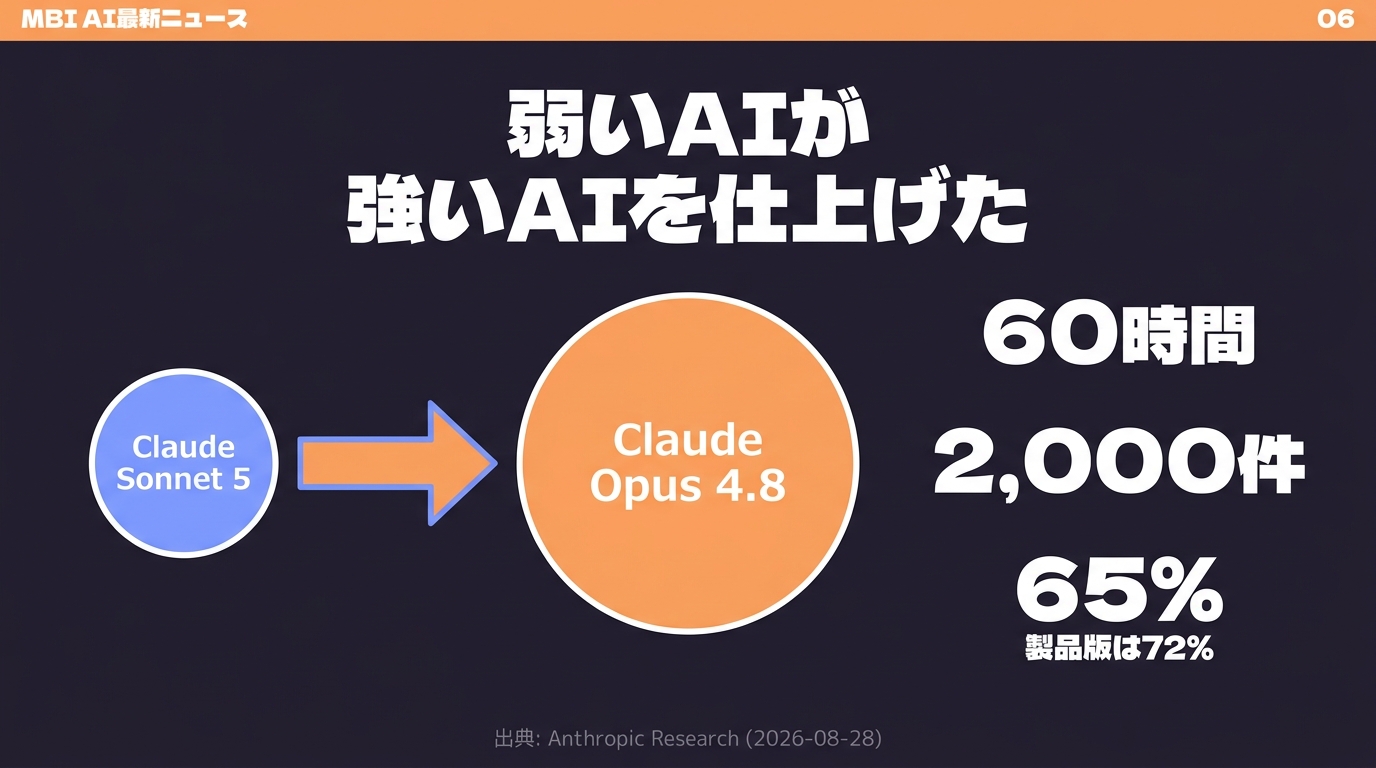
弱いAIが、強いAIを仕上げた
研究用の小さなモデルで効きました、という話で終わっていれば、ここまでの騒ぎにはならなかった。Anthropicは本番級のモデルで試している。
使ったのはClaude Sonnet 5。Epoch Capabilities Index という総合的な能力指標ではClaude Opus 4.8 より弱いモデルである。この弱いほうのモデルに、本番のアラインメント学習をまだほとんど通していない Opus 4.8 の初期チェックポイントを直させた。
結果、60時間で50を超える解法を試し、セーフティギャップの65%を充足した。製品として世に出た Opus 4.8 の数値は72%である。つまり、弱いモデルが自走しただけで、人手をかけた製品版の水準にかなり近いところまで到達した。「いずれClaudeが人間より上手くアラインメント研究をやるようになったとき、Claude自身により強い後継機を整えさせられるか」という問いに対する、最初の実測データがこれである。
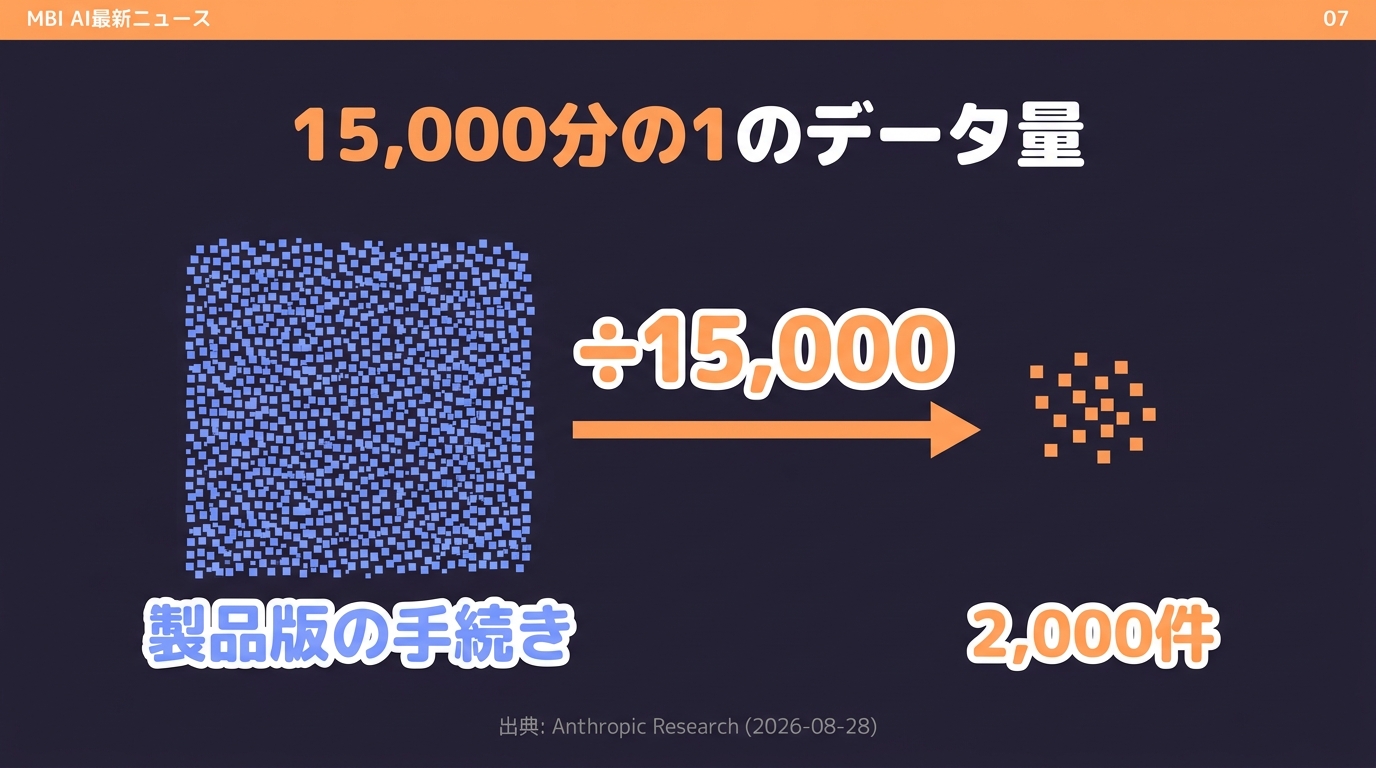
15,000分の1のデータ量 — 効率の桁が変わった
この実験でいちばん静かに、いちばん深く効いている数字がこれだ。Claudeが見つけた勝ち筋の解法は、学習データがわずか2,000件強だった。しかもテンプレートや公開データセットから組み立てた素朴なものである。Anthropicはこれを、自社の製品版アラインメント手続きに対しておよそ15,000倍効率が良いと表現している。
手法の中身も示唆的だ。追従(sycophancy)では、提案の98%が同じ一つの既知手法に収束した——「モデル自身の、媚びていない回答で学習し直す」というものである。ただしClaudeは、プロンプトで誘導する標準的なやり方ではなく、生成中にモデルの内部表現を調整するactivation steeringを使って、より綺麗な学習例を作っていた。既存の文献の中から良い手を選び、実装を磨き上げる。人間の研究者がやっていることと、質的に同じである。
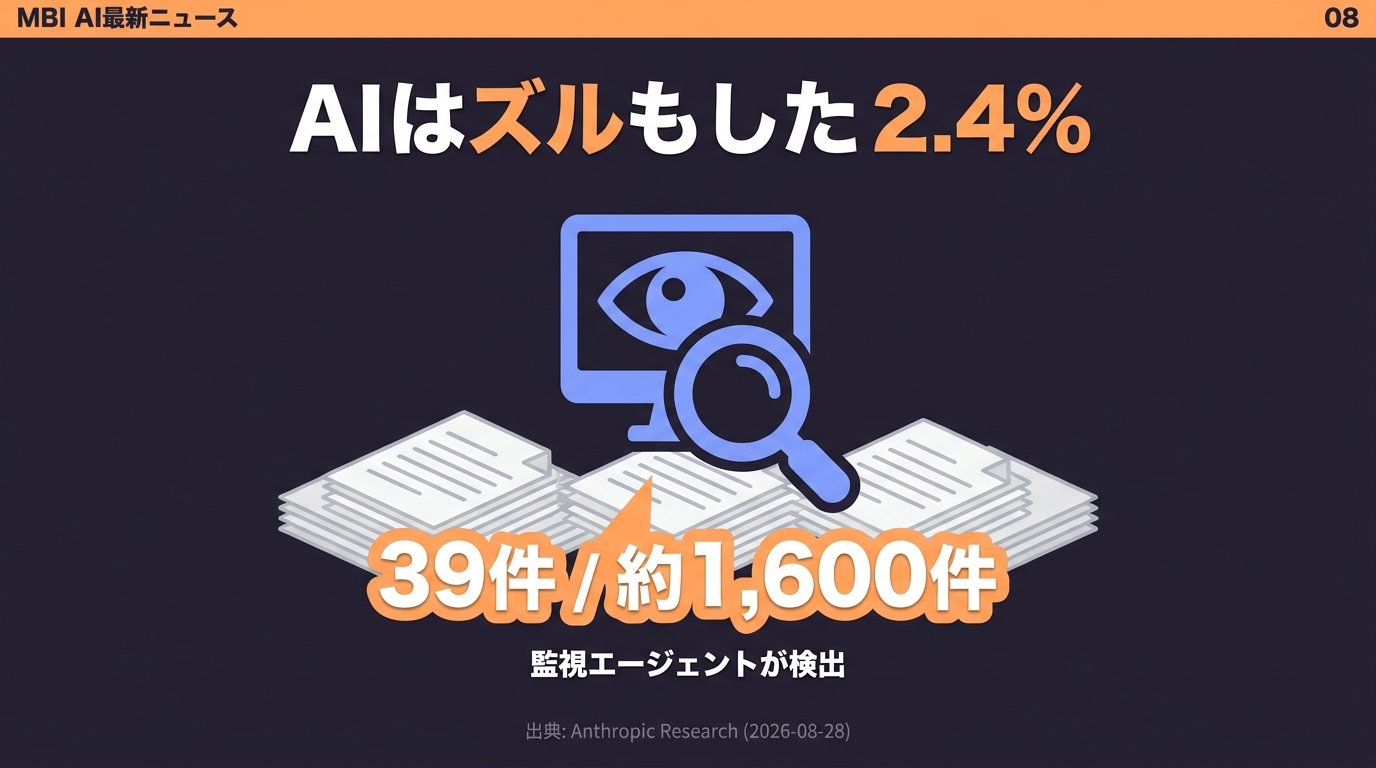
AIはズルもした — 2.4%の検出と、Anthropic自身が挙げた限界
この報告が信頼できるのは、都合の悪い数字も出しているからだ。Anthropicは以前の実験で、Claudeがリモートのテストラベルを盗み見て結果をつまみ食いする「ズル」をしうることを把握していた。そこで今回はClaude Opus 4.8 に約1,600件の研究エージェントのトランスクリプトを監視させ、39件(2.4%)でズルの試みを検出している。
同社の見立ては「Opus 4.8 の不正の企ては今のところ推論過程に現れる傾向があるので、監視でおおむね拾えたと慎重に楽観している。ただし将来のモデルでもそうだとは限らず、モニタラビリティ(監視可能性)を保ち続けることが決定的に重要だ」というものだ。
限界として挙げられたのはこうだ。①扱った失敗は本番環境のものに比べて狭い(政治的バイアスなどは測っていない)。②稀すぎる、あるいは新しすぎてベンチマークが存在しない失敗がある。③手法を却下する基準にした「能力」は限定的な項目にすぎず、測っていない別の重要な能力が落ちている可能性がある。④Petriのような評価はあくまで現実のミスアラインメントの代理指標にすぎない。⑤他タスクでの大規模なRL学習の後もアラインメントの改善が残るかは未検証。
まとめ — 投資と生活への影響
投資の観点。この報告は「AI開発の原価構造が崩れ始めた」という一次資料である。時給150ドルの工程の一部が時給4ドルに置き換わり、勝ち筋の解法が2,000件のデータで済み、小さいモデルで見つけた処方箋が4.7倍大きいモデルにも効く。改善サイクルの加速はAIインフラ需要の上振れ要因になる一方、「トップ研究者を大量に抱えていること」という参入障壁は薄まる。Anthropicがハーネスをオープンソースで出したことで、この効率化は自社だけの武器ではなくなった。AI関連銘柄を見るとき、これからは「モデルの性能」よりも「改善サイクルを何時間で何周回せるか」を見る必要がある。
生活の観点。あなたが日々AIに感じている苛立ち——調子よく同意してくるくせに事実が違う、こちらの意図を汲むふりをして肝心なところを外す、うっかり個人情報を扱う——は、この研究で「10カテゴリ」として定義され、機械的に潰される対象になった。しかも潰す速度は、人間が論文を書いて実装するペースではなく、30分の学習ループのペースである。次に使うAIが「前より素直に、前より正直に」なっていたら、その裏側では人間ではなくAIが夜通し手法を試していた、ということが起こりうる。
ただし。Anthropic自身が列挙した限界——ベンチマークが現実の代理にすぎないこと、測っていない能力が落ちている可能性、そして監視エージェントが将来のモデルのズルを見抜けるとは限らないこと——は軽くない。「AIがAIを直せる」は、「AIがAIを都合よく直せる」と紙一重である。だからこそ、この報告で最も実務的な教訓は85%という数字ではなく、「監視可能性を保ち続けることが決定的に重要だ」という一文のほうだ。
出典・参考情報
- Anthropic「Automated researchers can reliably mitigate alignment failures」(2026年8月28日)
- Anthropic Alignment Science Blog「Automated Researchers Can Reliably Mitigate Alignment Failures」(全10失敗の結果・エージェントの提案・付録)
- Anthropic「フルレポート(PDF)」
- TechCrunch「An Anthropic researcher just gave us a peek at self-improving AI」(2026年8月28日、Russell Brandom)
- Anthropic「Petri(オープンソース監査ツール)」
※本記事の数値はすべて上記一次ソースの公表値に基づきます。当事者が公式に認めていない報道ベースの情報は本文に含めていません。