AI関連ニュース
Google「Gemini 3.5 Transcribe」公開 — 文字起こしは1時間$0.30。だが効くのは単価ではなく「後処理が要らない」こと
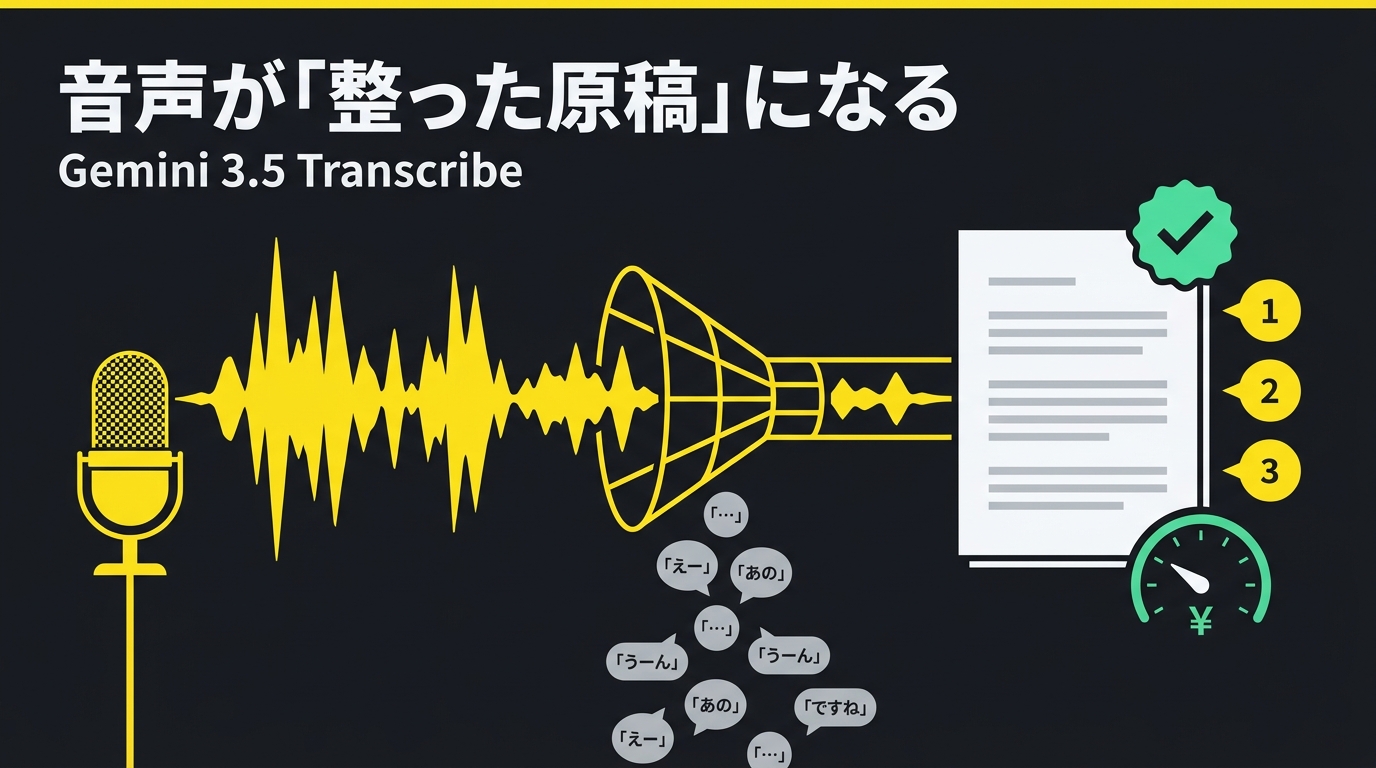
Googleが2026年8月26日、音声認識の新モデル「Gemini 3.5 Transcribe」をパブリックプレビューで公開した。単語誤り率は非ストリーミングで2.6%、ストリーミングで4.0%(Artificial Analysis計測)。確定までの時間は従来モデルChirp 3比で70%短縮し、85言語以上を自動判別、最大3話者を単語単位のタイムスタンプ付きで識別する。料金は録音が実効で1分あたり約$0.005(1時間約$0.30)、リアルタイムが約$0.009(同約$0.54)。単価では最安ではないが、フィラー除去・自動整形・カスタム語彙まで込みで「読める原稿」を返すため、文字起こしSaaSが粗利を得てきた後処理レイヤーが基盤モデルに吸収される構図となる。
① Googleが音声認識の新モデルを公開した
Googleは米国時間の2026年8月26日、音声をテキストに変換する新しいモデル「Gemini 3.5 Transcribe」を公開しました。現時点ではパブリックプレビューという位置づけで、開発者は Gemini API と Google AI Studio から、企業は Gemini Enterprise Agent Platform から利用できます。
提供されるのは2種類です。ひとつは録音済みの音声ファイルを処理する gemini-3.5-transcribe。会議の録音、コールセンターの通話ログ、講義といった「あとから文字にしたい」音声を、話者の区別と単語単位のタイムスタンプ付きで書き起こします。もうひとつが gemini-3.5-transcribe-live で、こちらは WebSocket 上の双方向ストリーミングに対応し、1秒未満の遅延でリアルタイムに文字を返します。
発表を書いたのは Gemini Audio のエンジニアリング担当シニアディレクター Diego Melendo Casado 氏と、同チームの Luke Leonhard 氏です。すでに Android の Gboard に搭載された「Rambler」機能と、macOS版 Gemini アプリの音声入力がこのモデルで動いており、今後 Chrome にも入る予定だと明記されています。
② 「聞き取る」から「書き上げる」へ
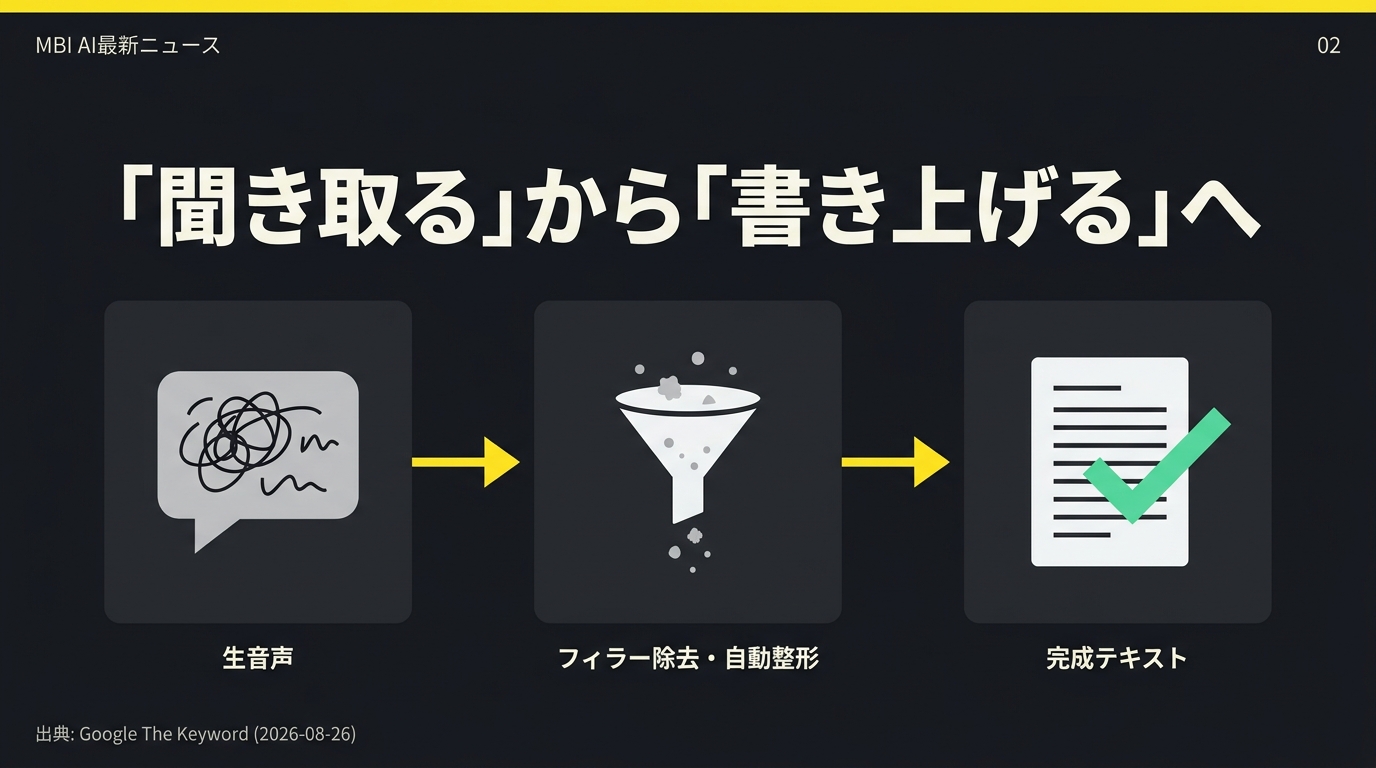
このモデルのいちばんの変化は、精度の数字よりも「何を返してくるか」にあります。従来の音声認識は、聞こえた音をそのまま文字に置き換えるところまでが仕事でした。ですから出力は「えーと、じゃあ火曜に、あ、いや水曜にしましょうか」のような、生のままのテキストです。使える形にするには、そのあとで別のモデルにもう一度通して、言い直しを反映し、フィラーを消し、句読点と改行を整える必要がありました。
Gemini 3.5 Transcribe は、その工程をモデルの内側でやってしまいます。公式の説明では、言い直しの処理、「えー」「あのー」といったつなぎ言葉の除去、そして自動整形が機能として挙げられています。さらに、ブランド名や商品名、業界用語といった独自の語彙をあらかじめ渡しておくと、それに合わせて表記を寄せてくれる。電話番号や郵便番号、注文IDのような英数字の並びも、精度を上げた項目として名指しされています。
つまり返ってくるのは「音の記録」ではなく「読める原稿」です。ここが、これまでのASR(自動音声認識)製品との線引きになります。
③ 精度は単語誤り率2.6%
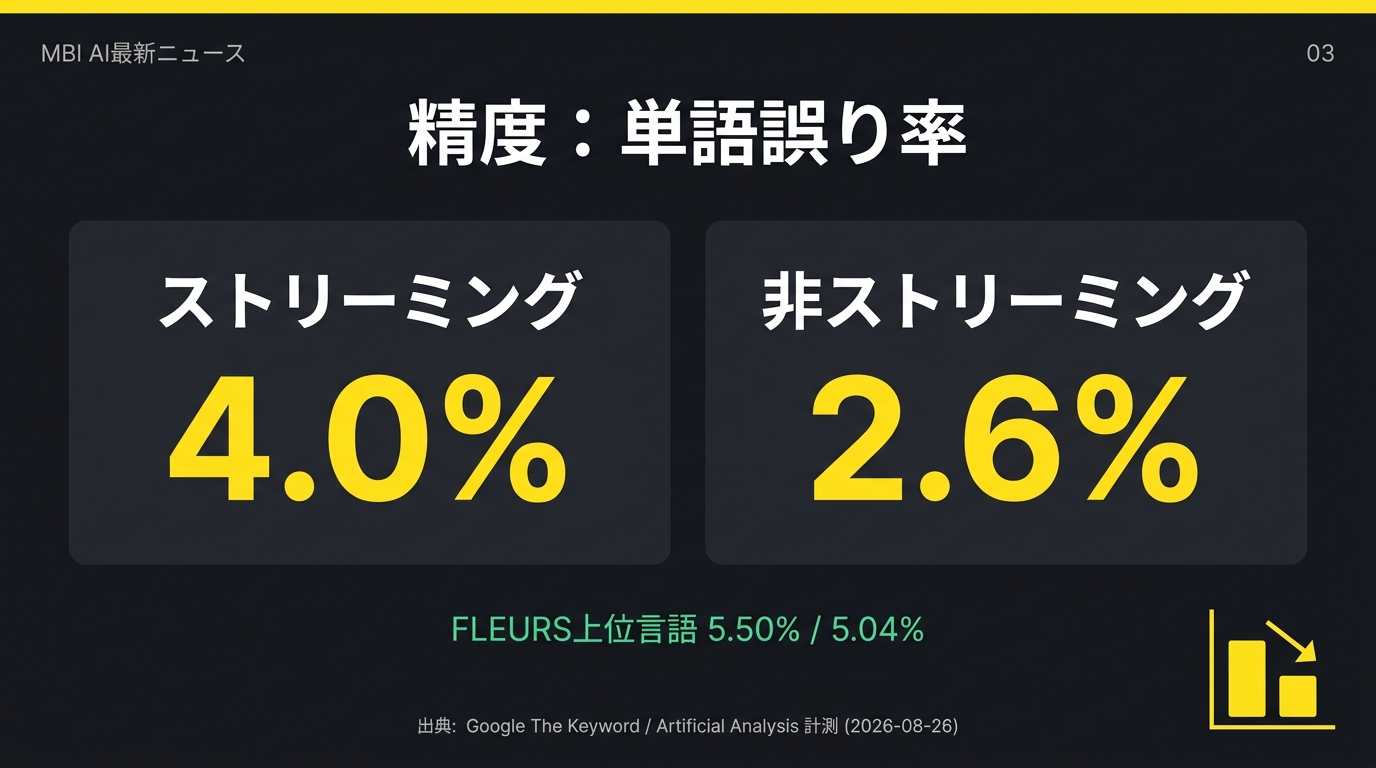
精度の指標としてよく使われるのが単語誤り率、WER(Word Error Rate)です。100語しゃべって何語まちがえたかを示す数字で、低いほど良い。Googleは第三者機関 Artificial Analysis の計測として、平均でストリーミング時 4.0%、非ストリーミング時 2.6% という値を公表しています。
多言語の共通ベンチマークである FLEURS の上位言語・ロケール群では、ストリーミング 5.50%、非ストリーミング 5.04%。日常会話ではなく読み上げに近い条件のベンチマークで、雑音や訛りを含んだ現実の音声よりは厳しめの数字が出やすい領域ですが、いずれも従来モデルの Chirp 3 から改善したとされています。
ここで注意しておきたいのは、これらがすべてGoogle自身の公表値だという点です。第三者計測を引用してはいるものの、比較対象として他社モデルの数値を並べた表は公式ブログにはありません。導入を検討する際は、自社の音声、自社の業界用語で実測することが前提になります。
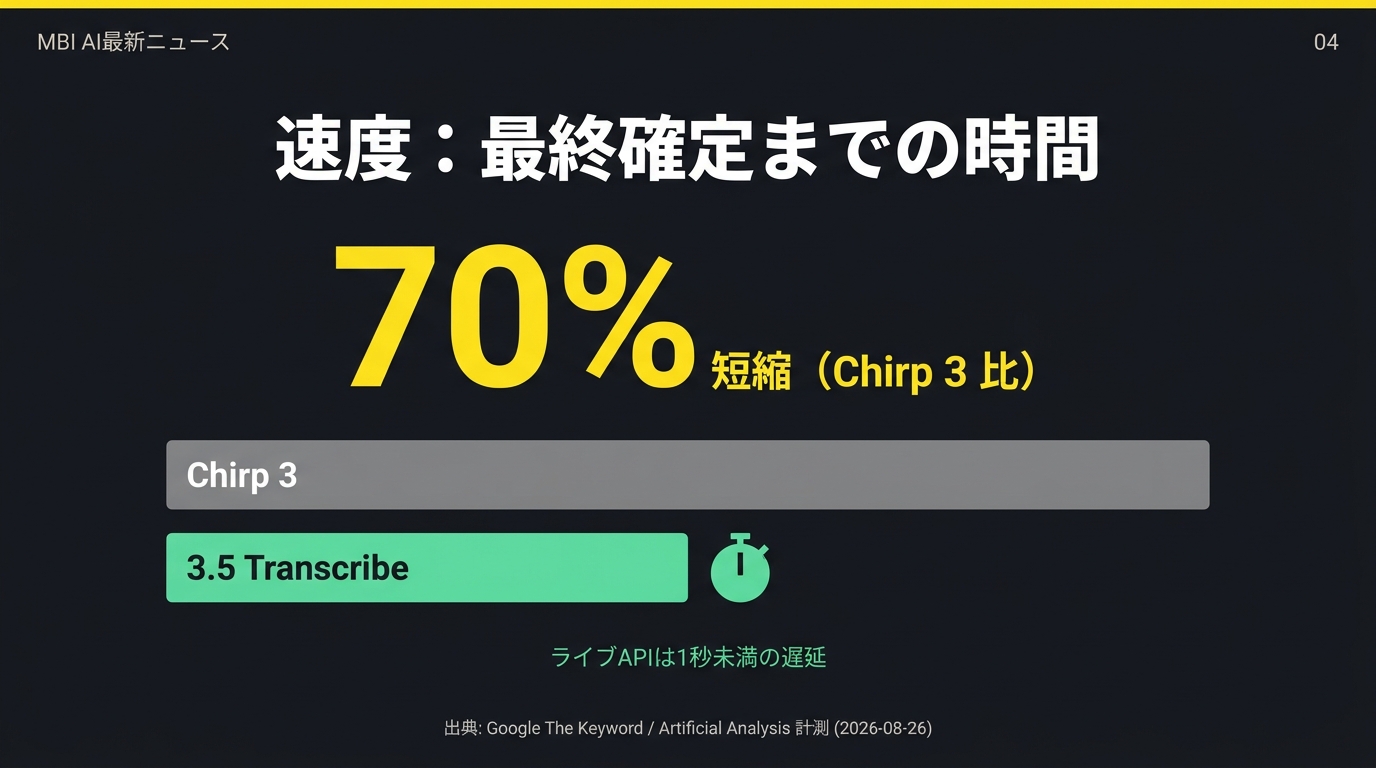
④ 待ち時間は70%短縮
実務でストレスになるのは、誤字の数よりも「いつ確定するか」です。リアルタイム文字起こしは、しゃべっている途中で暫定の文字を出し、あとから前の部分を書き換えます。この書き換えが終わって文が確定するまでの時間を、Googleは Artificial Analysis の計測として従来モデル比で70%短縮したと説明しています。
この差は、字幕や音声エージェントのような用途で体感に直結します。確定が遅ければ、画面上の文字が後から入れ替わる時間が長くなり、読み手が落ち着かない。エージェントであれば、ユーザーの発話が終わってから応答を始めるまでの間が伸びる。リアルタイム側の API が1秒未満の遅延を掲げているのは、この待ち時間の問題に正面から答えにいったということです。
実装面では、Agora、Fishjam、LangChain、LiveKit、Pipecat、Vercel、Vision Agents といった開発者向けプラットフォームがすでに対応しています。音声のリアルタイム配信インフラは自前で組むと重い領域なので、この対応リストの厚さ自体が導入コストを押し下げます。
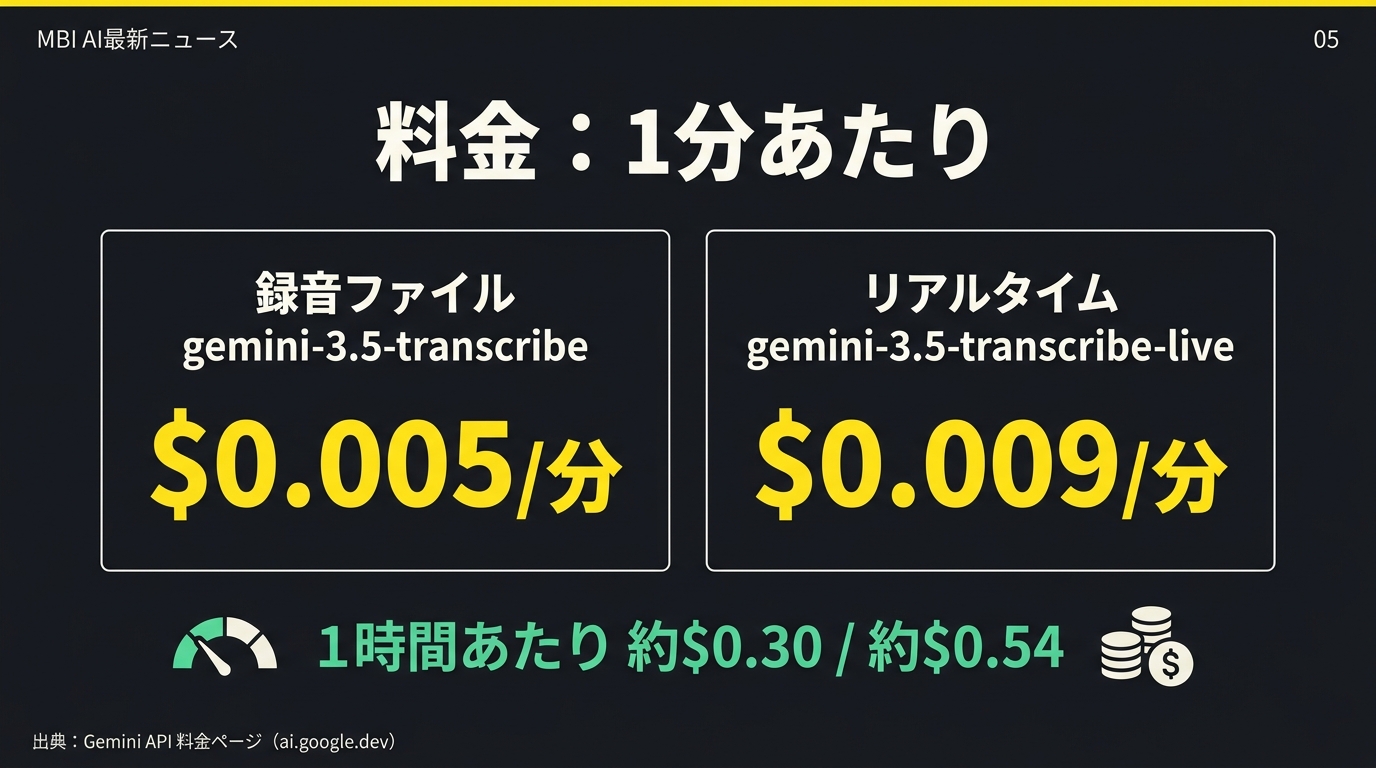
⑤ 料金は1時間およそ$0.30
Gemini API の料金ページによると、録音ファイル用の gemini-3.5-transcribe は音声入力が100万トークンあたり$2.00、テキスト出力が$12.00。音声は1秒あたり25トークンで課金されるため、Googleは実効レートを「1分あたりおよそ$0.005」と示しています。1時間に直すとおよそ$0.30です。
リアルタイム用の gemini-3.5-transcribe-live は音声入力$3.50、テキスト出力$21.00で、実効レートは1分あたりおよそ$0.009。1時間でおよそ$0.54になります。リアルタイム処理には常時接続の分だけ割増がついている、という構造です。
もうひとつ、見落とすと事故になる項目があります。料金ページには無料枠が用意されていますが、そこには「無料枠の入力はプロダクト改善に利用される/有料枠は利用されない」と明記されています。試すだけなら無料枠でよいものの、クライアントの音声や社内の機密会議を扱う実装は、最初から有料枠に載せる必要があります。
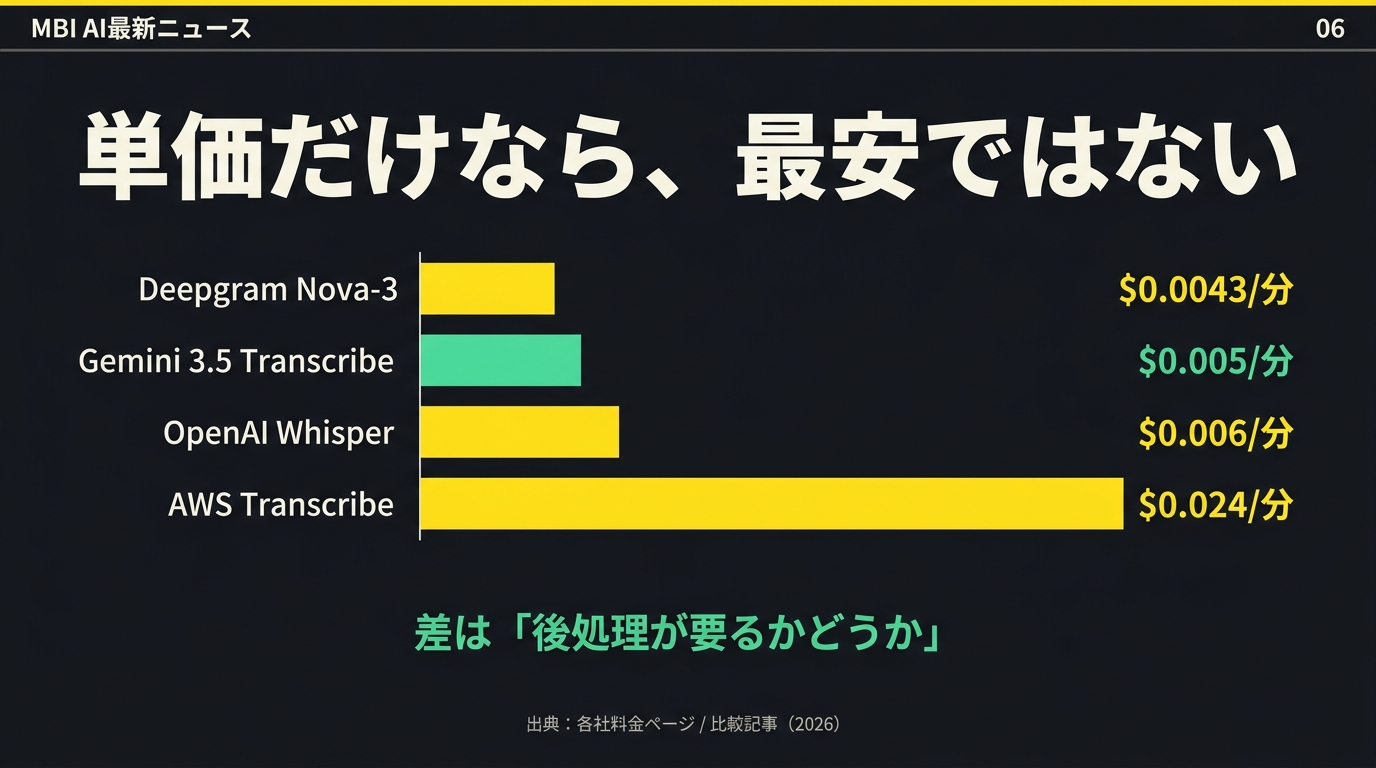
⑥ 単価だけなら、最安ではない
ここで冷静に比べておきます。音声認識APIの主要プレイヤーの価格は、2026年8月時点の比較記事によれば、Deepgram Nova-3 がバッチ$0.0043/分・ストリーミング$0.0077/分、OpenAI の Whisper API が$0.006/分、AWS Transcribe が$0.024/分、AssemblyAI の Universal-2 がバッチ$0.12/時(=$0.002/分)・ストリーミング$0.15/時。いずれも各社公表値ではなく比較記事に基づく二次情報である点は断っておきます。
この並びで見ると、Gemini 3.5 Transcribe の$0.005/分は「そこそこ安い」水準であって、最安ではありません。単純な単価競争では AssemblyAI や Deepgram が下に付けています。
それでもこの発表が効くのは、比較の土俵が違うからです。他社の単価は「音を文字にする」ところまでの値段で、そこから使える原稿にするには、たいてい別途LLMを一回通す。その一回分のトークン代と待ち時間と実装の手間が、Gemini側では価格の内側に入っている。つまり争点は「1分いくら」から「完成品で出てくるか」へ移っている、というのが今回の本質です。
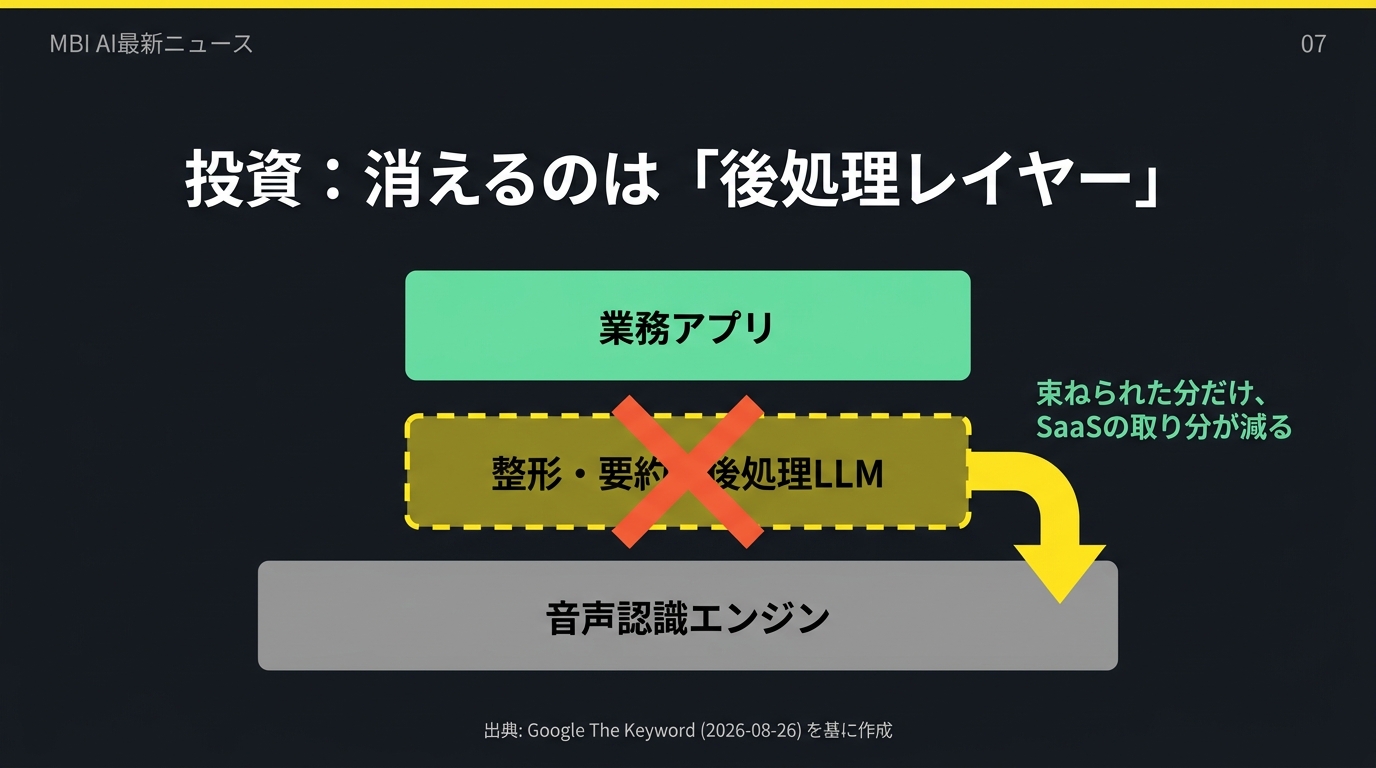
⑦ 投資:消えるのは「後処理レイヤー」
投資の観点で読むべきなのは、価格表ではなく製品構造の変化です。文字起こし系のSaaSは、これまで三層で価値を作ってきました。下に音声認識エンジン、真ん中に整形・要約・話者分離といった後処理、上に議事録や通話分析といった業務アプリ。粗利の多くは真ん中の層が生んでいました。エンジンだけならコモディティですが、「使える形にして返す」ところにお金を払ってもらえたからです。
今回のモデルは、その真ん中の層を基盤モデル側に取り込みました。フィラー除去、自動整形、話者識別、カスタム語彙、そして他のGeminiモデルへの関数呼び出しまでが標準機能として入っている。SaaS側に残るのは、業種特化のワークフロー、既存システムとの接続、コンプライアンスといった上の層だけになります。
これは値下げ競争とは別種の圧力です。価格が下がるのではなく、機能が飲み込まれることで取り分が減る。同じことは翻訳、要約、OCRでも起きてきました。中間レイヤーで食べている企業は、上か下、どちらかに移らないと居場所がなくなる——今回の発表は、その線がまた一段上がったという合図です。
⑧ 生活:入口がキーボードから声へ
生活の側では、配布経路の広さが効いてきます。すでに Android の Gboard に「Rambler」として載っており、思いつくままにしゃべると、つなぎ言葉を落として整った文章になる。声で誤字を直したり、文体を変えたりもできます。macOS版の Gemini アプリでは、話すだけでローカルファイルの要約や画像生成といった作業まで、他のGeminiモデルに引き渡して実行させられる。さらに Chrome にも搭載予定で、ウェブ上のあらゆる入力欄を音声で埋められるようになります。
これが意味するのは、文章入力の初期状態が「打つ」から「しゃべる」に寄る、ということです。移動中の返信、議事録、問い合わせフォーム、SNS投稿。85言語以上を自動判別して訛りや方言も扱うと説明されているので、日本語で始めて英語に切り替わっても止まりません。
一方で、注意すべき点も残ります。まだプレビュー段階であり、料金や仕様は変わりえます。話者識別は3人までが正式対応で、4人以上の会議は実験扱い。入力は96kトークンまでで、長時間の録音は分割が必要です。そして無料枠のデータ利用の扱い。使い始める前に、この4点だけは確認しておくべきです。
まとめ
Googleが2026年8月26日に公開した Gemini 3.5 Transcribe は、単語誤り率が非ストリーミングで2.6%、確定までの時間が従来比70%短縮という数字を掲げつつ、より重要な変化を静かに済ませています。返ってくるのが「音の記録」ではなく「読める原稿」になったことです。
1時間あたりおよそ$0.30という価格は、最安ではありません。しかし他社の単価が「音を文字にするまで」の値段であるのに対し、こちらはフィラー除去も自動整形も話者識別も込みです。これまで音声認識の後段に必ず置いていた整形用のLLM呼び出し——文字起こしSaaSの粗利の源泉だった中間レイヤーが、基盤モデルの標準機能に吸い上げられました。
投資家が見るべきは価格表ではなく、この構造です。中間レイヤーで稼ぐビジネスは、上の業務ワークフローか下のインフラか、どちらかに逃げなければ縮んでいく。生活者が見るべきは配布経路です。Gboard、Gemini for macOS、そして近くChrome。文章を書き始める初期状態が、打つからしゃべるに寄っていきます。まだプレビューであること、話者3人までの制限、無料枠のデータ利用条件——この3点だけは、使い始める前に必ず確認してください。
出典・参考情報
- Google The Keyword「Intelligent transcription with Gemini 3.5 Transcribe」(2026年8月26日/Diego Melendo Casado, Luke Leonhard)
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-5-transcribe/ - Google DeepMind「Gemini Audio – AI transcription」モデル情報ページ
https://deepmind.google/models/gemini-audio/ai-transcription/ - Gemini Developer API 料金ページ
https://ai.google.dev/gemini-api/docs/pricing - Gemini API 音声文字起こしドキュメント
https://ai.google.dev/gemini-api/docs/transcribe - 9to5Google「Google launches Gemini 3.5 Transcribe, which powers Gboard Rambler & is coming to Chrome」(2026年8月26日)
https://9to5google.com/2026/08/26/gemini-3-5-transcribe/ - 他社STT価格は各社公表値ではなく、2026年8月時点の比較記事(AssemblyAI / Deepgram / FutureAGI 等)に基づく二次情報です。