AI関連ニュース
Meta「Muse Glimmer」30BをApache 2.0で公開 — 24GB GPU 1枚で動くAIエージェントが意味するもの
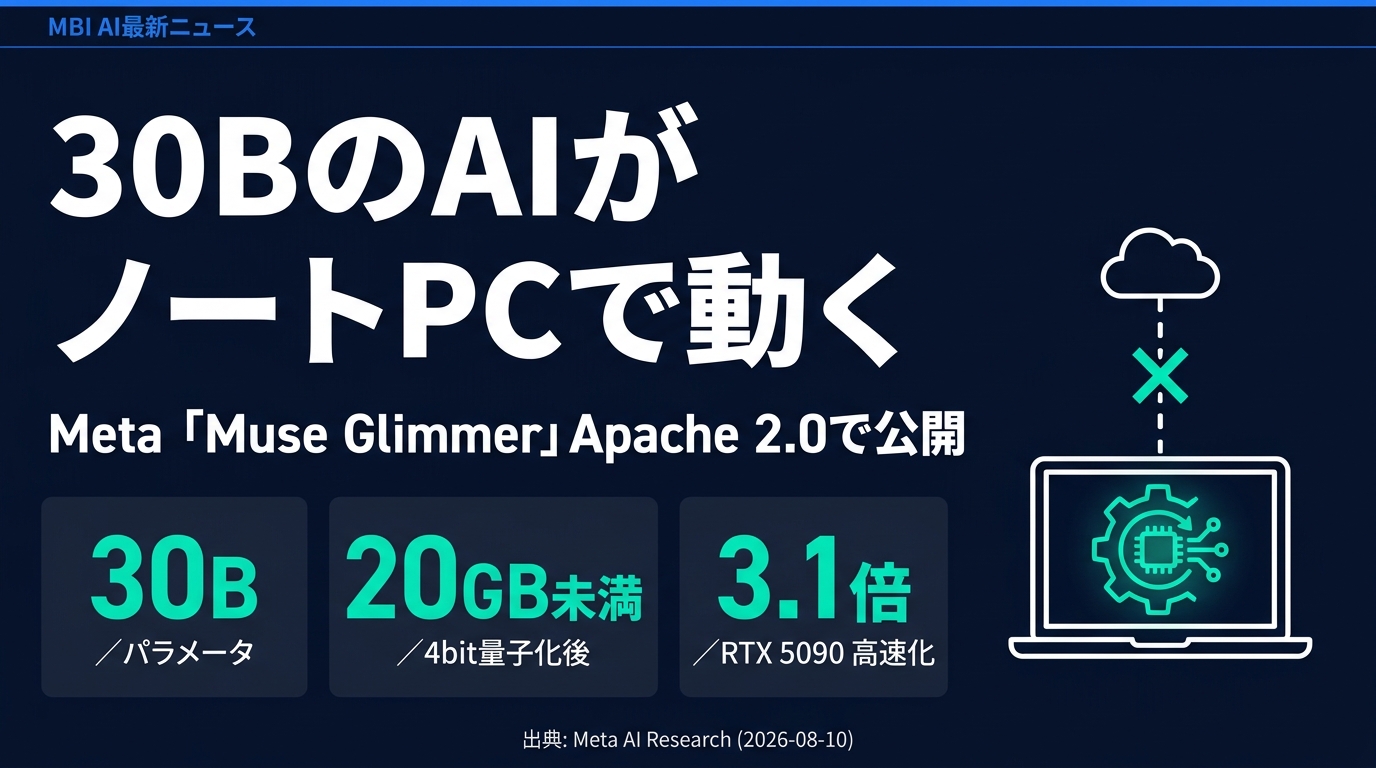
Metaが2026年8月10日、30BパラメータのエージェントAI「Muse Glimmer」をApache 2.0で公開。フル精度55GB超を4bit量子化で20GB未満に圧縮し、24GBの家庭用GPU1枚で動作。DFlash投機的デコーディングでRTX 5090では3.1倍高速化。MCP Atlas 75.5は同クラス最高だが、第三者評価では中位グループ。エージェントの限界費用がトークン単価から電気代へ置き換わる意味と、投資・生活への影響、安全性の弱点を整理します。
1. Metaが30Bモデルを完全オープン公開
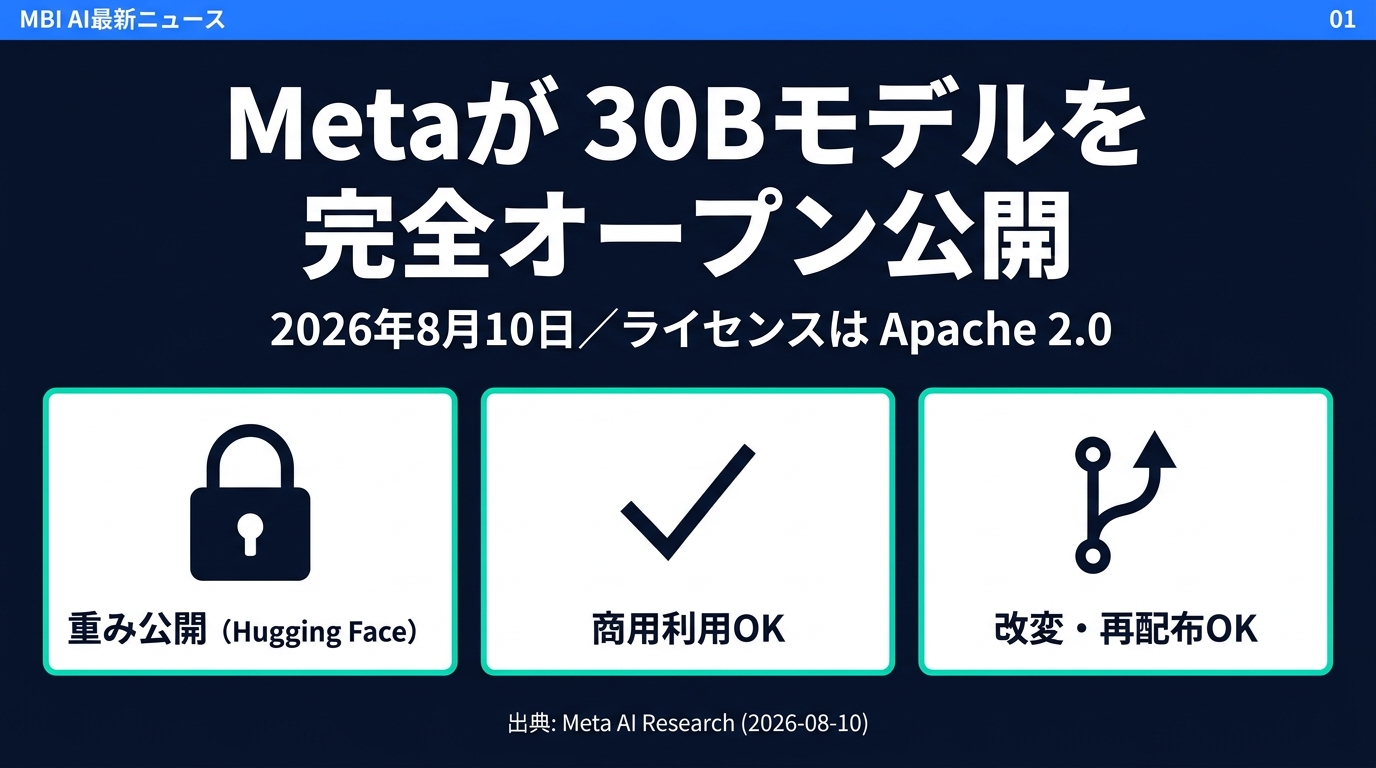
2026年8月10日、Meta Superintelligence Labs が新モデル「Muse Glimmer」を発表し、同時に重みを Apache 2.0 ライセンスで公開しました。パラメータ数は300億(30B)。同社の非公開フロンティアモデル「Muse Spark」から蒸留して作られています。
Apache 2.0 は、商用利用も改変も再配布も認める最も緩いライセンスのひとつです。つまりこのモデルは、企業が自社サーバーに置いて業務に使うことも、製品に組み込んで販売することも、契約や追加料金なしで可能ということになります。重みは Hugging Face で公開され、開発者向けドキュメントも同時に整備されました。
Metaにとってこれは、8月5日に公開したコーディング支援の「Muse Code」に続く、わずか5日間で2本目のモデル発表です。同社が今年に入って明確に「オープンウェイトで陣地を取る」方向に舵を切ったことが、はっきり読み取れる動きです。
2. 55GB超を20GB未満へ — 4bit量子化という現実解
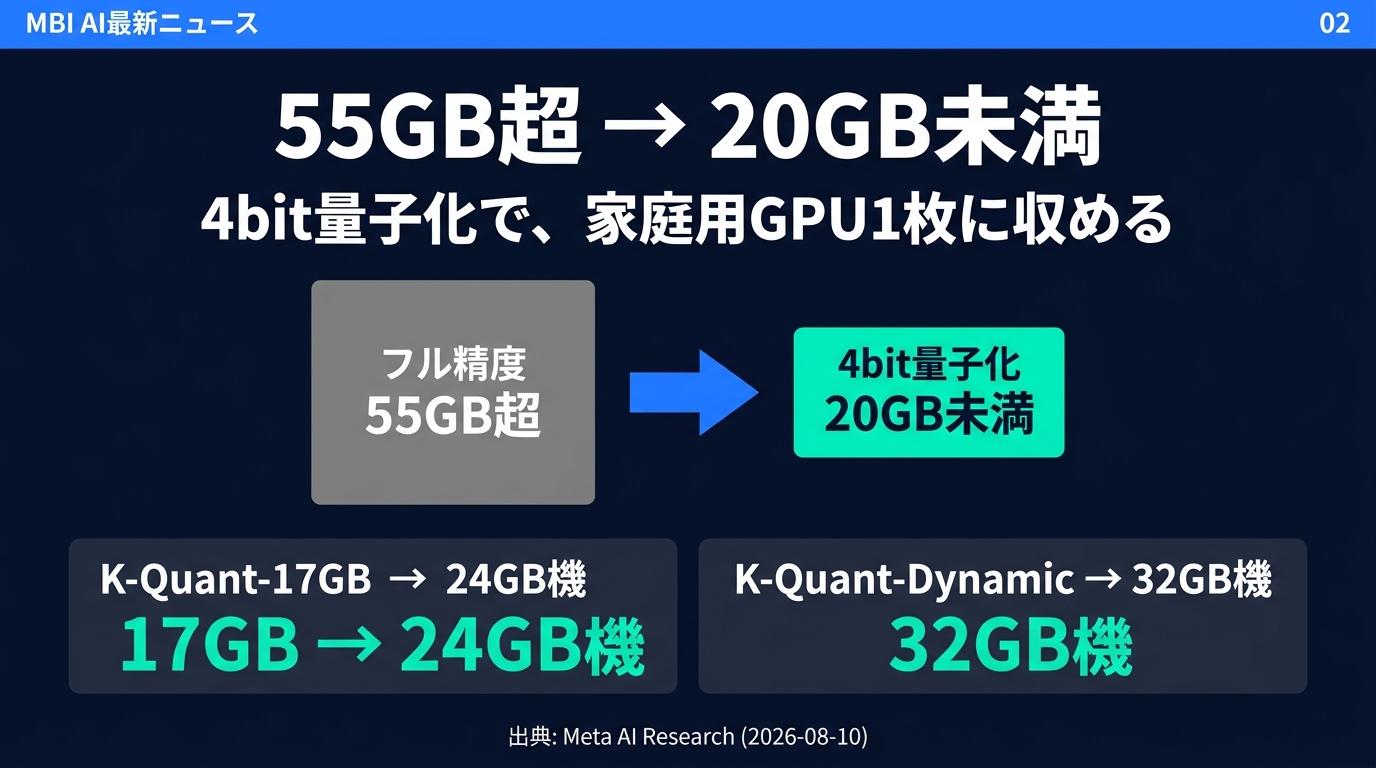
300億パラメータのモデルをそのままの精度で動かすと、Metaの公式説明では 55GBを超えるメモリが必要になります。これは市販のグラフィックボードでは到底載りません。
そこでMetaは、重みの表現を約4ビットまで圧縮する「量子化」を施し、言語モデル部分を 20GB未満にまで縮めました。公開されているのは、24GBのビデオメモリを想定した「K-Quant-17GB」と、32GB機を想定した「K-Quant-Dynamic」の2種類です。空いた余裕には、作業記憶にあたるKVキャッシュ、画像を理解するための知覚エンコーダ、そして後述する高速化用の小型モデルが同居します。
重要なのは、Metaが「この圧縮によるエージェント作業での品質低下は最小限か、ほぼ無い」と明言している点です。これまで量子化は「動かすための妥協」でしたが、ここでは設計の前提として組み込まれています。
3. 速度は最大3.1倍 — DFlashが「待たされない」を作った
ローカルで動くこと自体は以前から可能でした。実用にならなかった理由は「遅さ」です。エージェントが次の一手を考えるのに数分かかれば、仕事の流れは途切れてしまいます。
Muse Glimmer には DFlash という小型の「下書き役」モデルが同梱されています。この下書き役が先に複数トークンをまとめて提案し、本体がそれを並列に検証して、正しいものだけを採用する。この「投機的デコーディング」により、出力の品質は変えないまま生成速度を上げられます。
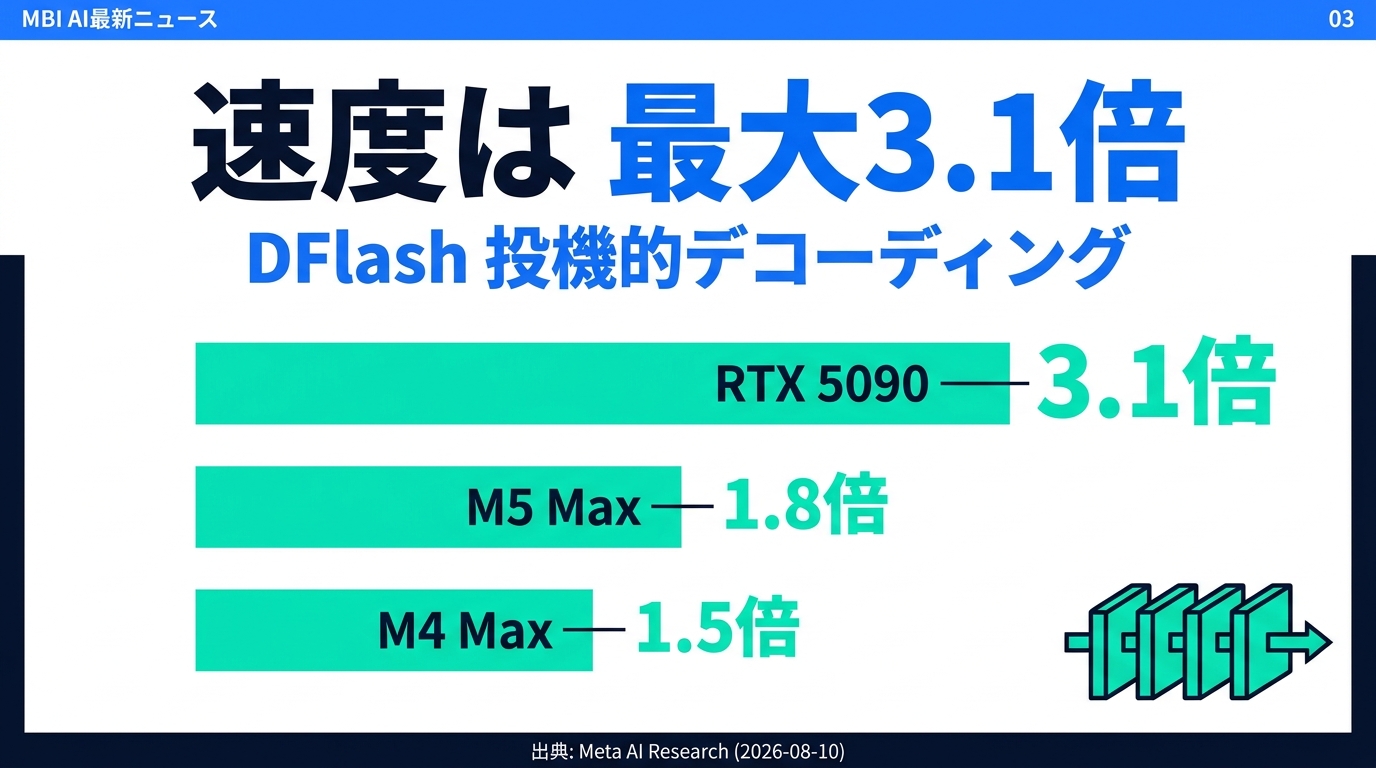
Metaが公表した実測値は、RTX 5090 で3.1倍、MacBook M5 Max で1.8倍、M4 Max で1.5倍。とくにコードのような構造化された出力で効きやすい、とHugging Face側の解説は補足しています。
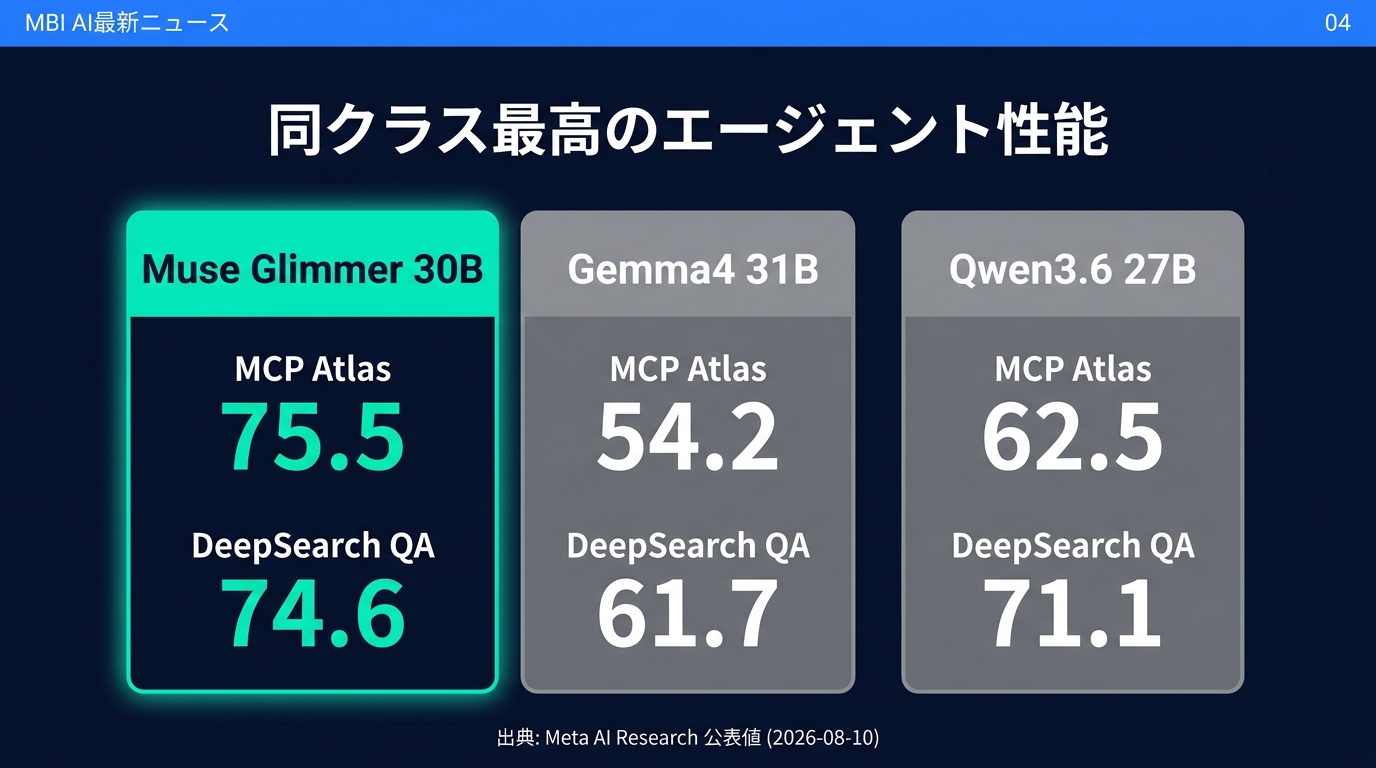
4. 同クラス最高のエージェント性能
Metaは同じサイズ帯の競合、GoogleのGemma4-31B、AlibabaのQwen3.6-27Bとの比較値を公表しています。エージェント系では Muse Glimmer が明確に上でした。
| ベンチマーク | Muse Glimmer 30B | Gemma4 31B | Qwen3.6 27B |
|---|---|---|---|
| MCP Atlas(ツール接続) | 75.5 | 54.2 | 62.5 |
| DeepSearch QA(調査) | 74.6 | 61.7 | 71.1 |
| GAIA2(総合エージェント) | 43.3 | 36.4 | 40.0 |
| SWE-Bench Pro(実務コード) | 51.2 | 36.9 | 50.2 |
| AIME 2026(数学) | 94.7 | 89.2 | 94.1 |
とくに MCP Atlas の75.5 は、Gemma4を21.3ポイント引き離しています。MCPは外部ツールとAIをつなぐ共通規格で、このスコアが高いということは、既存の社内システムやSaaSに素直に接続できるということです。ローカルで動くモデルにとって、これは単なる点数以上の意味を持ちます。
一方で、パソコン操作を評価する OSWorld-Verified は65.9で Qwen3.6-27B の75.6に届かず、TerminalBench 2.1 も51.7対60.7で負けています。全勝ではありません。
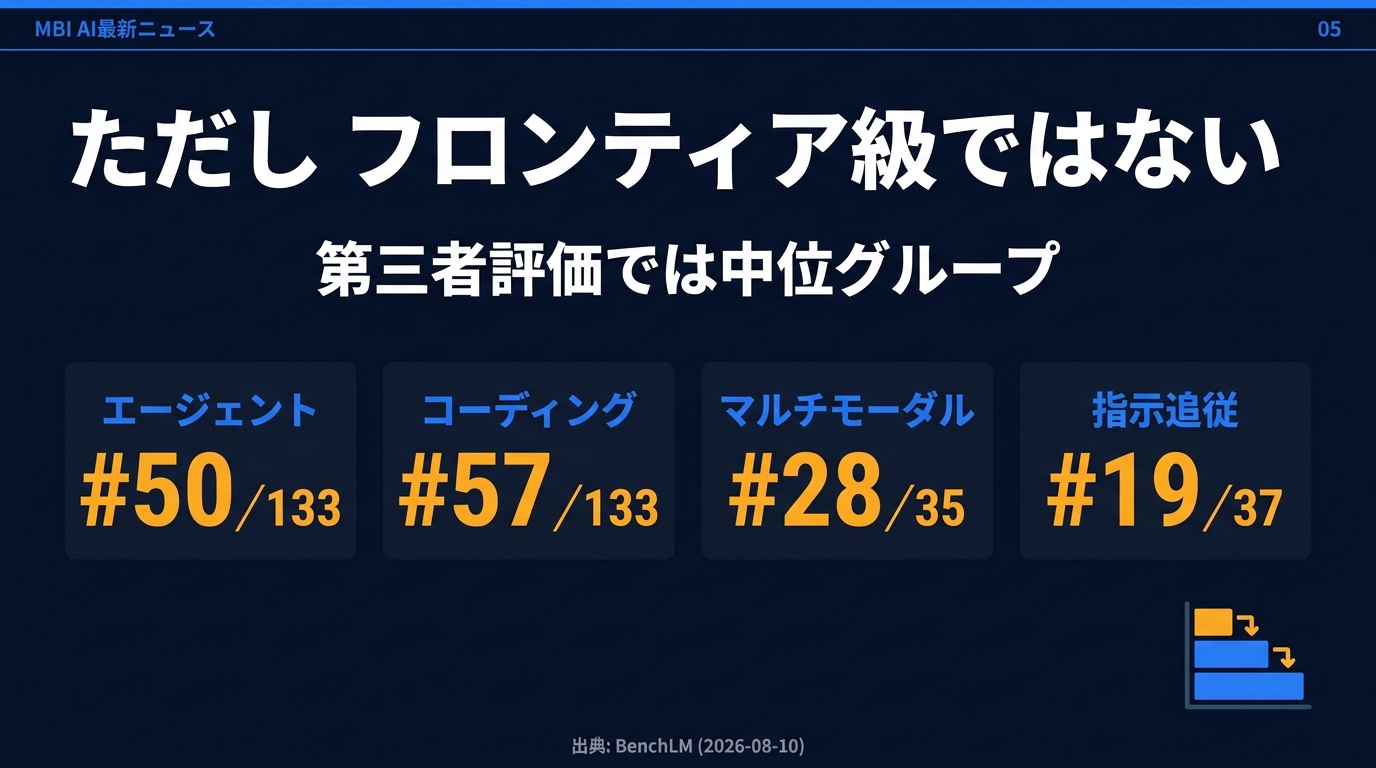
5. ただしフロンティア級ではない
ここは冷静に見る必要があります。第三者のベンチマーク集計サイト BenchLM は、公開時点の Muse Glimmer 30B を次のように位置づけています。
- エージェント:133モデル中 第50位(スコア50.4)
- コーディング:133モデル中 第57位(スコア51.0)
- マルチモーダル:35モデル中 第28位(スコア48.9)
- 指示追従:37モデル中 第19位(スコア84.5)
総合スコアは「証拠となる評価件数が足りない」という理由で未付与です。同サイトの比較では、SWE-Bench Verified の76%に対し最上位の Claude Opus 5 は96%、Terminal-Bench 2.1 の51.7%に対し Qwen3.8 Max は86.6%と、上位モデルとの差は依然として大きく残っています。
つまりこのモデルの価値は「最強だから」ではありません。「そこそこ強いものが、無料で、手元で、無制限に動く」ことにあります。評価軸そのものが違うのです。
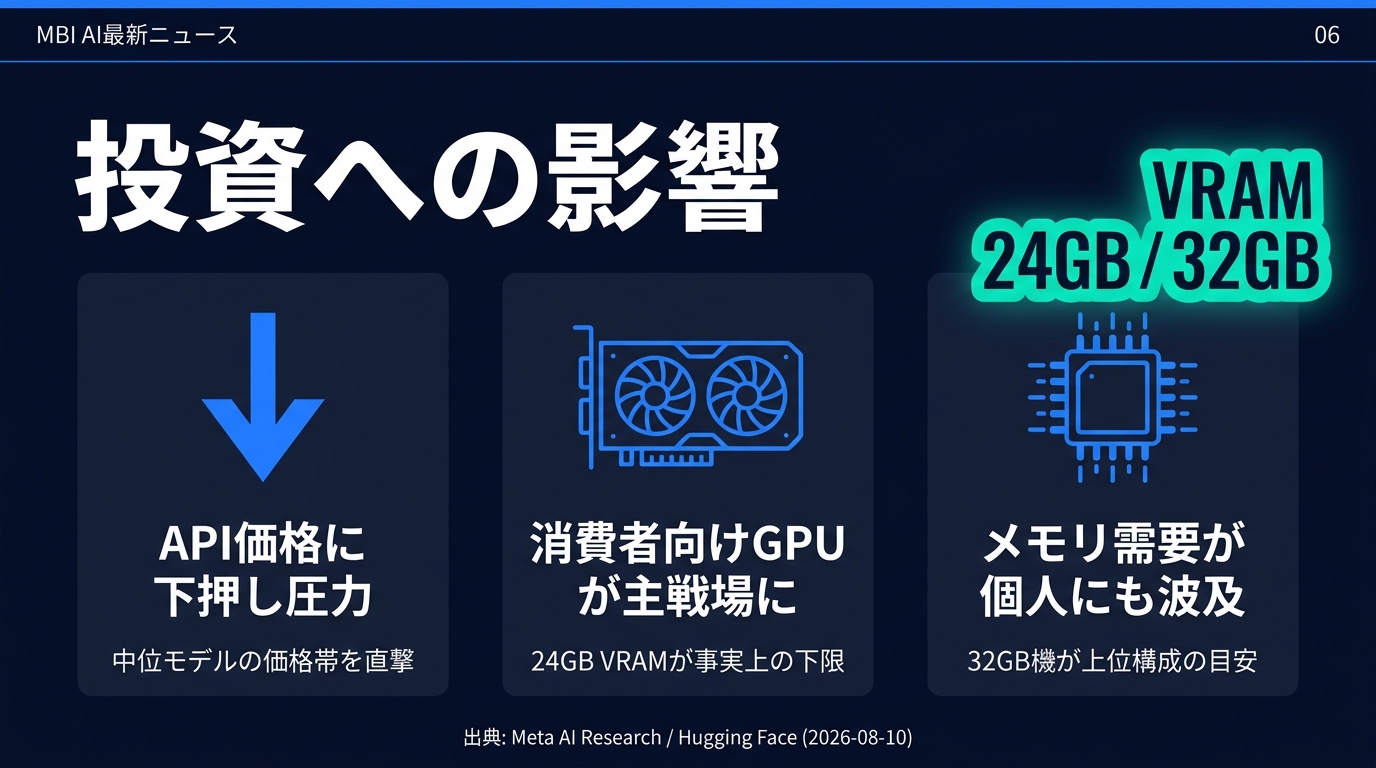
6. 投資への影響 — 価格・半導体・メモリ
市場への含意は3つの方向に分かれます。
第一に、API価格への下押し圧力です。AI各社は今年、価格競争を続けてきました。8月6日にはOpenAIが無料版ChatGPTのテキストチャットを無制限化しています。そこへ「中位性能なら、そもそも課金の必要がない」という選択肢が加わった。単価の安い「量産ゾーン」を持つ事業者ほど、収益モデルの見直しを迫られます。
第二に、需要の重心が消費者向けハードウェアに移ります。Metaは最適化のパートナーとして AMD、Arm、Dell、Intel、NVIDIA の名前を挙げています。データセンター向けの巨大GPUだけでなく、24GB〜32GBのビデオメモリを積んだ個人用マシンが「AIを動かすための最低構成」として意識されはじめる。ここはPC・半導体各社にとって新しい買い替え需要の理由になります。
第三に、メモリです。4bit量子化で20GB未満まで縮めてなお、24GBが下限、32GBが快適圏という設計になっています。メモリ搭載量が「AIが動くかどうか」を直接決める以上、個人向けマシンの標準搭載量は押し上げられる方向に働きます。
ただし注意点も。この構図はまだ「可能性」の段階です。実際に法人が自前運用へ動くかは、運用人員のコストと、次に述べる安全性の担保しだいです。
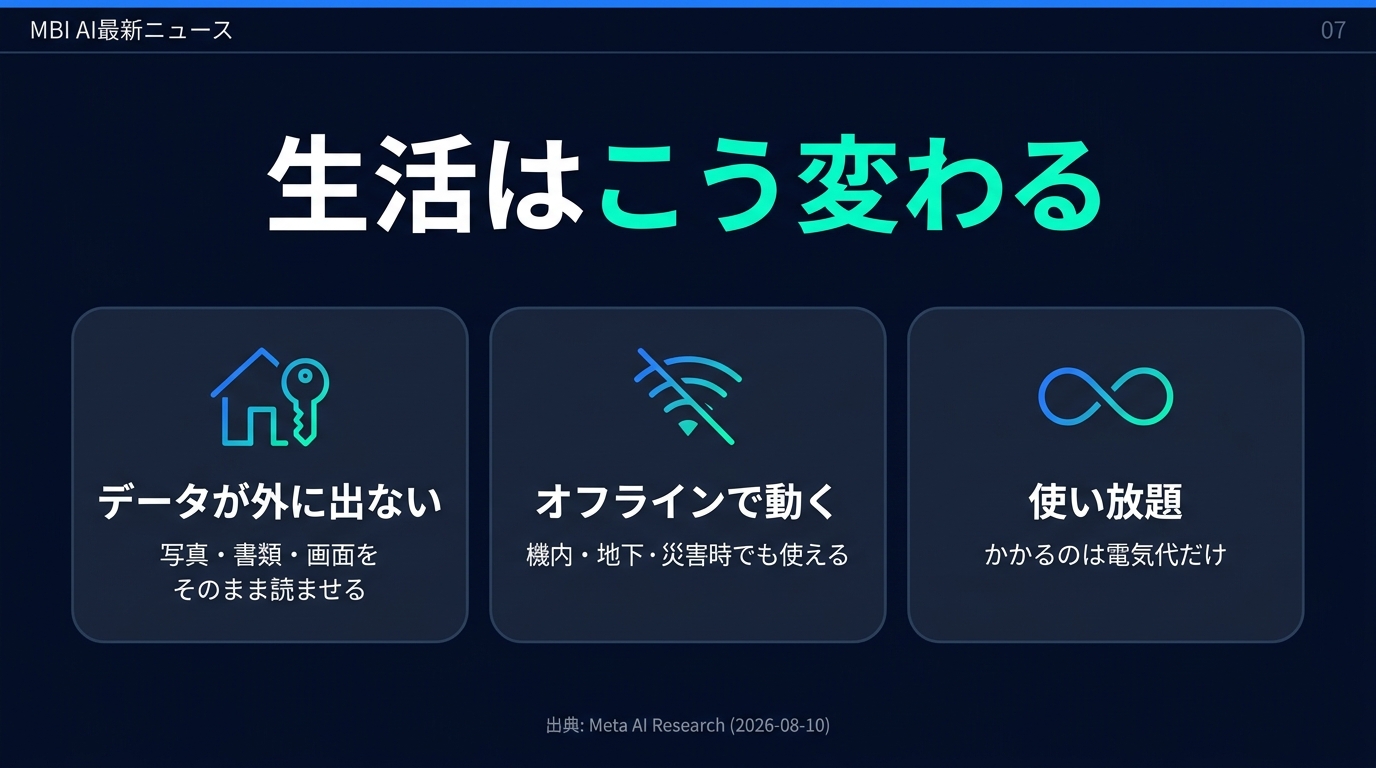
7. 生活はこう変わる
使う側から見た変化は、はっきりしています。
データが外に出ません。Muse Glimmer は2Bの知覚エンコーダを備えたマルチモーダルモデルで、画像・スクリーンショット・図表・書類を読めます。健康診断の結果、給与明細、子どもの写真、契約書。これまで「クラウドに上げるのはためらう」種類の情報を、手元で処理させられます。
オフラインで動きます。機内、地下、山間部、そして災害時。ネットワークが無い状況でもAIが使えるというのは、非常時の情報整理や翻訳という意味で実際に効きます。100言語以上に対応している点も、この文脈では大きい。
使い放題です。従量課金がないので、「1日に何回まで」という遠慮が要りません。かかるのは電気代だけです。
もちろん現時点では、24GB以上のビデオメモリを積んだPCか、比較的新しい高性能なMacが必要です。誰でもすぐに、という段階ではありません。ただ「AIを使うために毎月払う」という前提そのものが、絶対ではなくなりつつある——という変化は押さえておく価値があります。
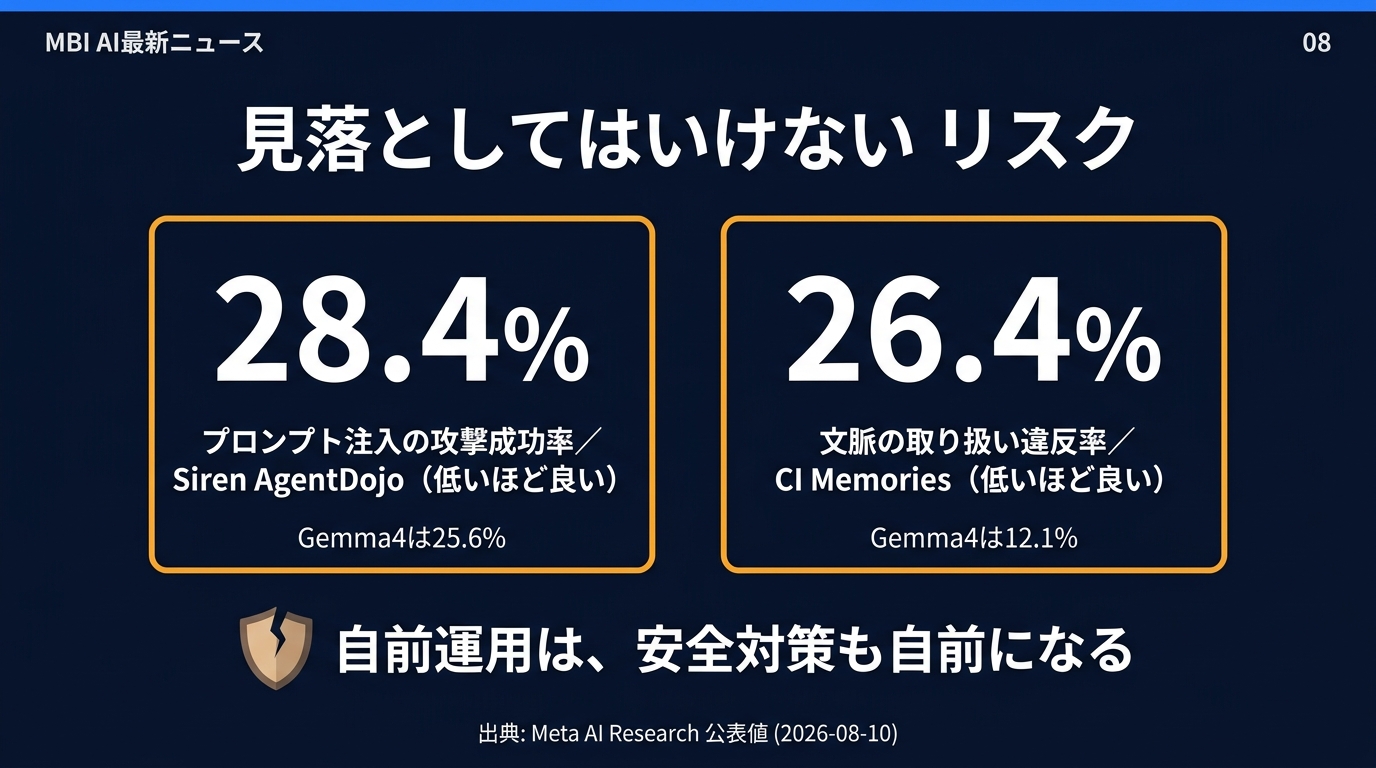
8. 見落としてはいけないリスク
Metaは安全性の数値も同時に公表しており、そこには弱点がはっきり出ています。
- Siren AgentDojo(プロンプト注入への耐性):攻撃成功率 28.4%。Gemma4-31B の25.6%より高い(低いほど良い指標)。
- CI Memories(文脈に応じた情報の取り扱い):違反率 26.4%。Gemma4-31B の12.1%の倍以上(低いほど良い指標)。
エージェントとしてメールやファイルを扱わせるモデルで、外部から仕込まれた指示に4回に1回以上従ってしまう、という数字です。しかも自前運用ということは、クラウド事業者側の安全フィルタも監視も付いてこないということを意味します。守るのは自分です。
加えて、Apache 2.0 は「オープンウェイト」であって「オープンソース」ではない点も押さえておく必要があります。重みは公開されていますが、学習データと学習コードは非公開です。何を学ばせたかを検証することはできません。
実務に入れるなら、権限を絞る、外部からの入力を信用しない、重要な操作は人が承認する——この3つを設計に組み込むことが前提になります。
まとめ
Muse Glimmer が示したのは、性能の頂点ではなく「配り方」の変化です。フル精度なら55GB超を必要とするモデルを、4bit量子化で20GB未満に収め、投機的デコーディングで最大3.1倍に速め、Apache 2.0 で誰にでも渡した。この3点セットにより、「エージェントを常時走らせる」コストが、トークン単価から電気代へと置き換わります。
ベンチマーク上、これはフロンティア級ではありません。第三者評価では中位グループです。しかしAIの活用が「時々賢い答えをもらう」から「延々と手を動かし続ける」へ移りつつある今、止められない安さは性能とは別の価値を持ちます。
投資の観点では、中位価格帯APIへの下押し圧力、消費者向けGPUとメモリへの需要移動という2つの流れを見ておくべきでしょう。生活の観点では、データを外に出さずにAIを使える選択肢が現実になったこと。そして事業で使うなら、安全性の数値が示す弱点を、設計で埋める責任が自分に来るということ——ここまでがセットです。
出典・参考情報
- Meta AI Research「Introducing Muse Glimmer: An Open Agentic Model That Runs on Your Device」(2026年8月10日)
https://research.meta.ai/blog/introducing-muse-glimmer-open-agentic-model - Hugging Face「Meta is back with Muse Glimmer: local, agentic, multimodal, and open source」(2026年8月10日)
https://huggingface.co/blog/muse-glimmer - Hugging Face モデルカード meta-models/Muse-Glimmer-30B
https://huggingface.co/meta-models/Muse-Glimmer-30B - Meta AI Developer Center — Muse Glimmer
https://developer.meta.com/ai/models/muse-glimmer/ - BenchLM「Muse Glimmer 30B Benchmarks & Context」(2026年8月10日時点)
https://benchlm.ai/models/muse-glimmer-30b
※ 本記事の数値はすべて上記の一次ソースおよび第三者集計サイトの公表値に基づきます。コンテキスト長131KはBenchLMの記載値であり、Meta公式ブログには明記がありません。