AI関連ニュース
NVIDIA決算の前日に、OpenAIが自社チップの「実測値」を公開 — Jalapeño、GB300比で電力あたり1.7倍・遅延3.6倍。年内に自社インフラへ投入
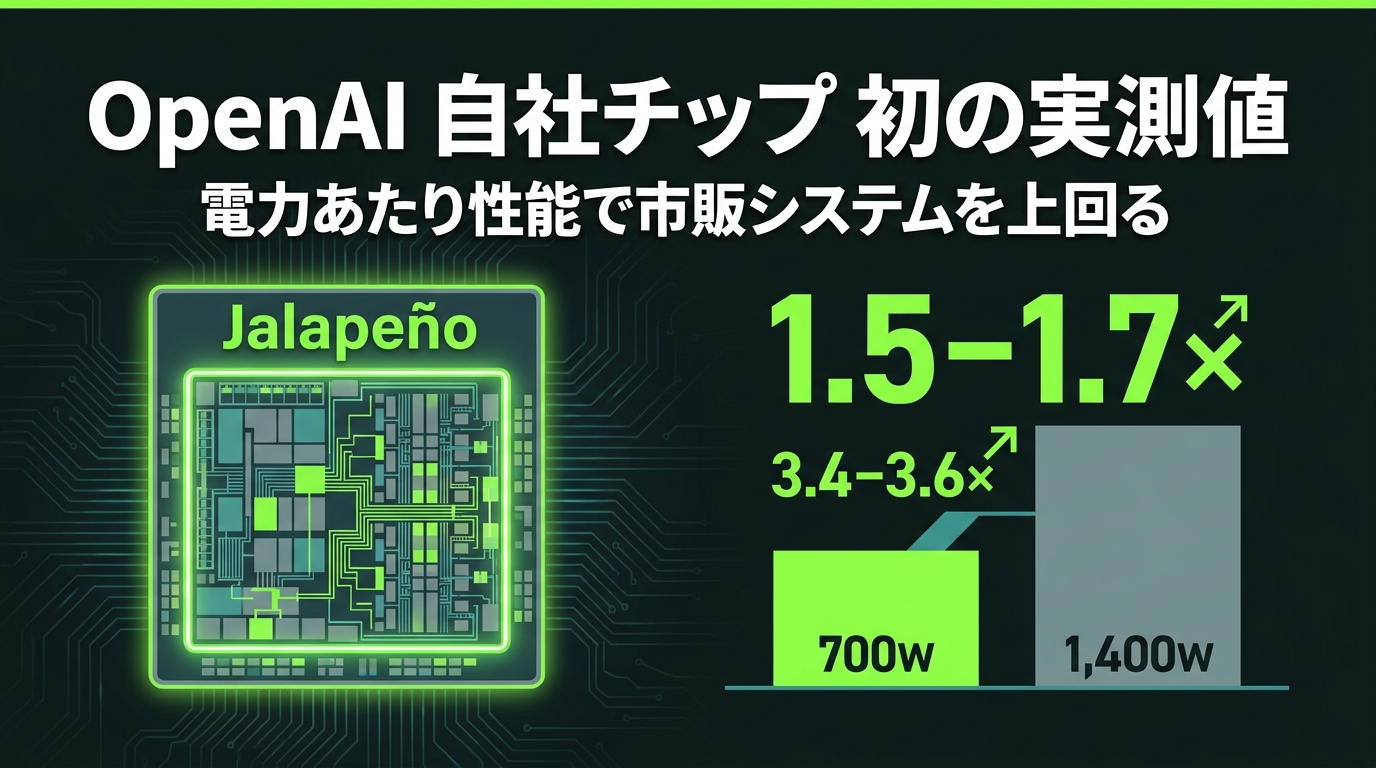
OpenAIが2026年8月25日、自社初のカスタム推論チップ「Jalapeño」の初の実測性能を公開。公開ベンチマークInferenceX上で、GPT-OSS 120B・DeepSeek R1 670B・Kimi K2.5 1Tの3モデルすべてにおいて、NVIDIA GB200/GB300を電力あたり性能で1.5〜1.9倍、エンドツーエンド遅延で1.7〜3.6倍上回った。設計からテープアウトまで9か月。NVIDIA決算の前日という発表タイミングと、CFO Sarah Friarの同時投稿が示す「価格交渉力」の意味を読み解く。
① NVIDIA決算の前日に出てきた「実測値」
2026年8月25日、OpenAIが自社初のカスタム推論チップ「Jalapeño」の初めての実測性能を公開した。翌8月26日はNVIDIAの第2四半期決算発表日(米国時間引け後)である。AI関連銘柄の値動きを最も大きく動かす一日の直前に、最大顧客のひとつが「自前のチップで、市販システムより電力あたり性能が高い数字が出た」と発表した——タイミングは偶然ではないだろう。
Jalapeñoは2026年6月にBroadcomとの共同開発として発表されていたが、これまで公開されていたのは設計思想だけだった。今回は違う。SemiAnalysisが公開している推論ベンチマーク「InferenceX」上で測った数字が、比較対象の消費電力とともに並べて出された。
そして同じ日、OpenAIのCFOであるSarah Friarが「The full stack behind abundant intelligence(潤沢な知能を支えるフルスタック)」と題した記事を出している。技術ブログと財務責任者の記事が同時に出るとき、それは技術の話ではなくコストと交渉力の話だと考えたほうがいい。
② 3つのモデルすべてで上回った
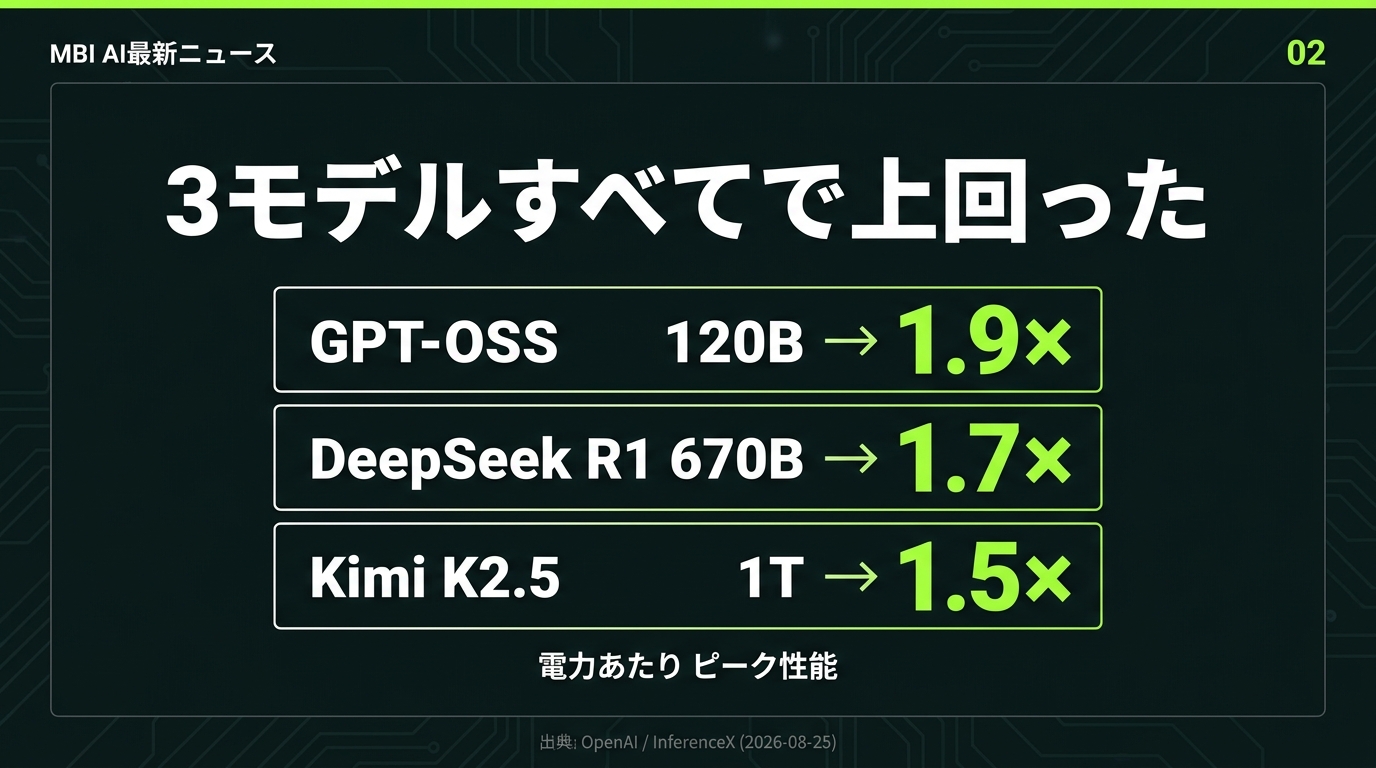
OpenAIはJalapeñoを3つの公開モデルで測った。GPT-OSS 120B、DeepSeek R1 670B、Kimi K2.5 1T——すべて外部から検証可能なオープンウェイトモデルで、自社の非公開モデルではない点は評価に値する。
結果は、3モデルすべてで比較対象を上回った。ピーク時の電力あたりスループットで1.5〜1.9倍、エンドツーエンド遅延で1.7〜3.6倍の改善。対話性の高い(=待ち時間にシビアな)ワークロードでは2.1〜4.1倍の性能差がついた。
| モデル | Jalapeño | 比較対象 | 倍率 |
|---|---|---|---|
| GPT-OSS 120B ピーク mixed TPS/kW | 85,448 | 44,960(GB200) | 約1.9倍 |
| DeepSeek R1 670B ピーク mixed TPS/kW | 19,641 | 11,781(GB300) | 約1.7倍 |
| Kimi K2.5 1T ピーク mixed TPS/kW | 18,195 | 11,862(GB300) | 約1.5倍 |
| DeepSeek R1 エンドツーエンド遅延 | 1.65秒 | 5.99秒 | 約3.6倍改善 |
| DeepSeek R1 最小TBT | 1.43ms(700 tok/s/user) | 5.90ms(169 tok/s/user) | 約4.1倍改善 |
もうひとつ目を引くのが、「従来の最速だった応答速度と同じ条件で比べると、処理量が104倍になる」という数字だ(DeepSeek R1、12,258 vs 118 mixed/kW)。これは倍率のマジックではなく、比較対象のシステムがその速度領域では極端に効率が落ちる——つまりそもそも想定されていない使い方だった、ということを意味する。
③ なぜ「1チップあたり」ではなく「1キロワットあたり」なのか
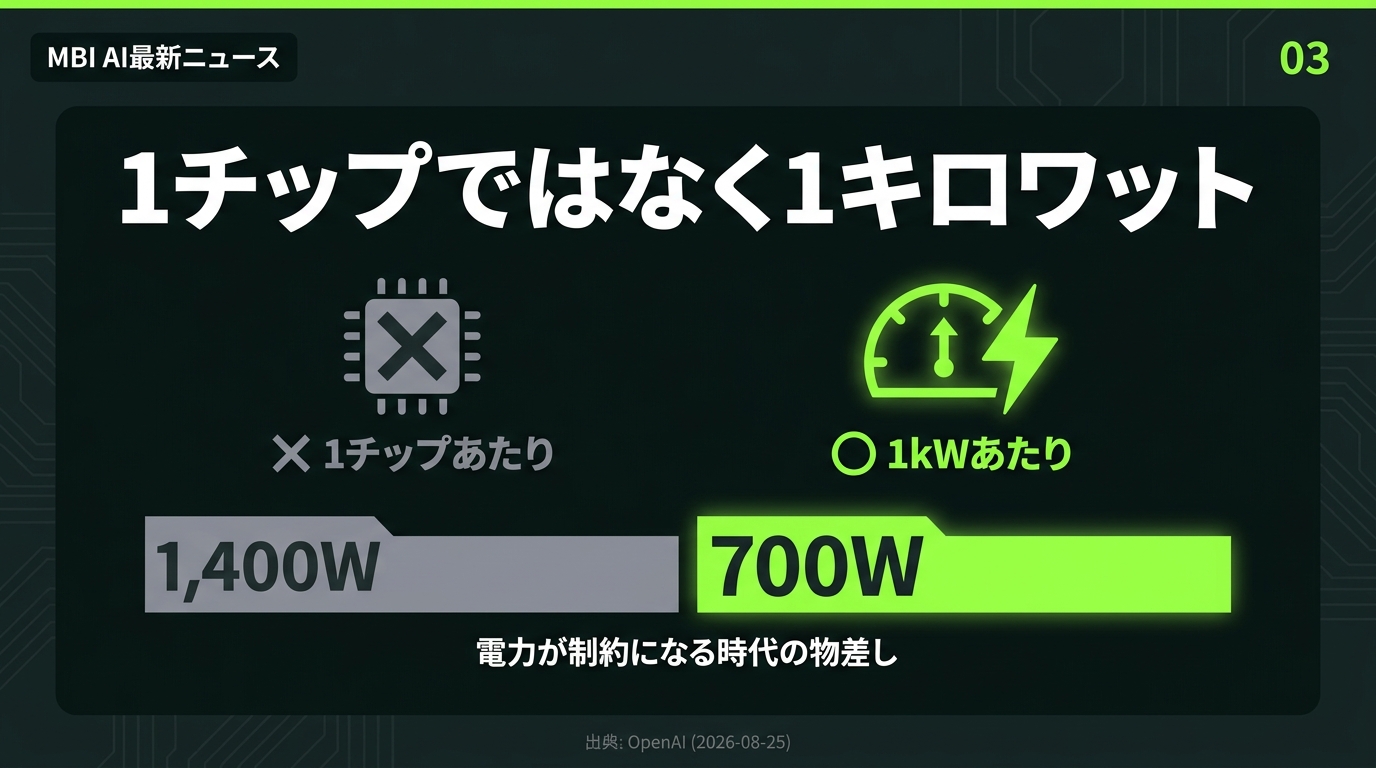
OpenAIは記事の中で、はっきりこう書いている。「性能は1チップあたりで報告されることがあるが、より有用な基準は単位電力あたりの性能だと私たちは考える」。
これは単なる測り方の好みではない。データセンターの制約がチップの調達数から、確保できる電力量へ移ったことの反映である。実際、Jalapeñoのパッケージ定格は700W、比較対象のGB200は1,200W、GB300は1,400W。同じラック、同じ受電容量に何枚積めるかが変われば、投下資本あたりの生産量が変わる。
ただし注意点もある。今回の正規化は各アクセラレータの「公称チップ電力」に基づくものだ。OpenAI自身、Jalapeñoの実測持続電力は700Wの定格に対して「550W以下だった」と書いている。つまり実測同士で比べれば差はさらに開く可能性がある一方、比較対象側の実測値は開示されていない。第三者による再現検証は、本稿時点でまだ出ていない。
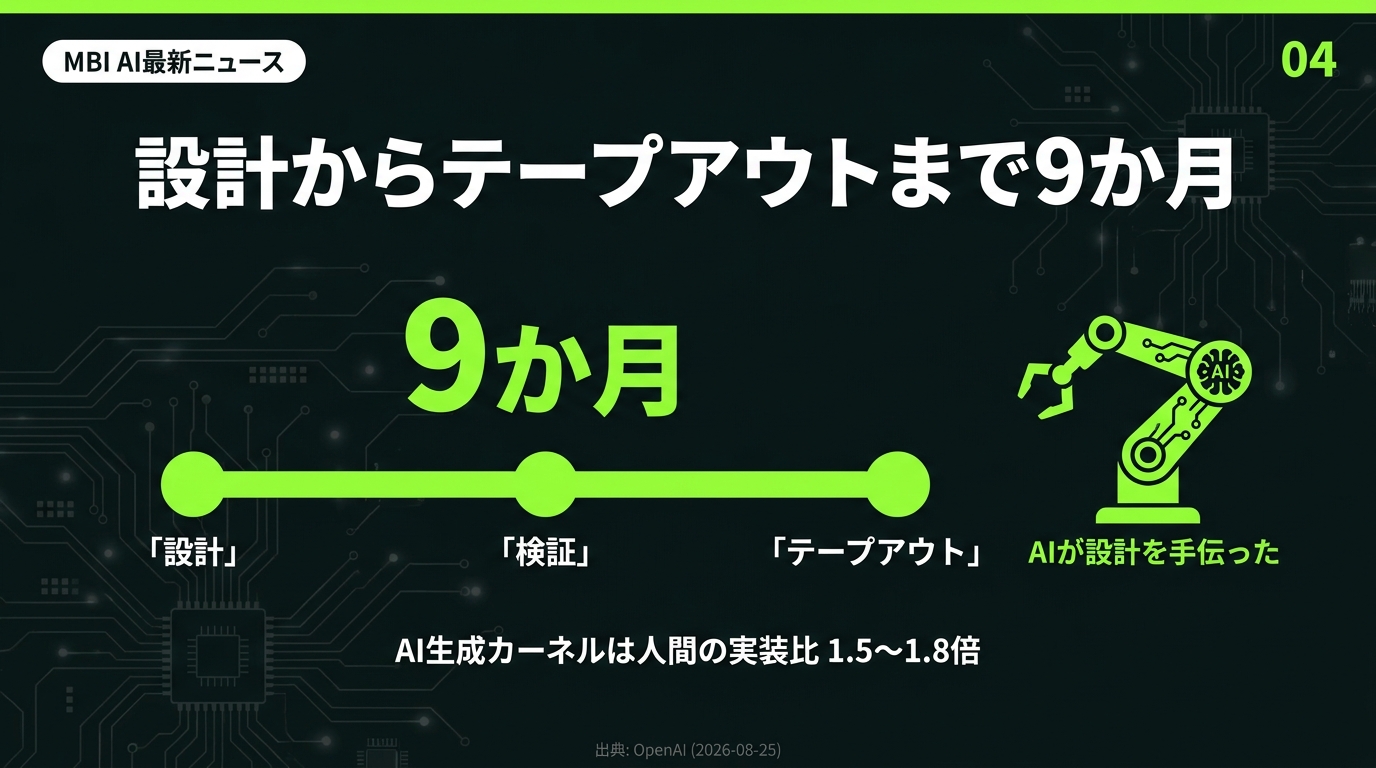
④ 設計からテープアウトまで9か月——AIが設計し、AIが最適化する
今回の発表でエンジニアが最も反応したのは、性能の数字よりもむしろ開発プロセスのほうだった。OpenAIによれば、Jalapeñoは初期設計からテープアウト(製造用データの確定)まで9か月で到達した。カスタムASICとしては異例の速さである。自社モデルが実装案の探索、設計・測定・検証ループの短縮、演算回路の最適化に直接使われた。
さらに実務的なのはソフト側だ。Jalapeñoは「人間にもAIにも読みやすいプログラミング対象」として設計された。その結果、Codex と GPT-Astra を使い、当初の量産計画に入っていなかった3つのオープンウェイトモデルを2か月で高性能化できたという。そして選定したGPT-OSSのattention/MoEブロックでは、AIが生成した実装が人間の専門家の実装より1.5〜1.8倍高速だった。
OpenAIはこの数字について「選定したブロックについてであり、モデル全体ではない」と正直に限定を付けている。それでも、カーネル最適化という「最も職人的」とされてきた領域が、AIに明け渡され始めている事実は残る。
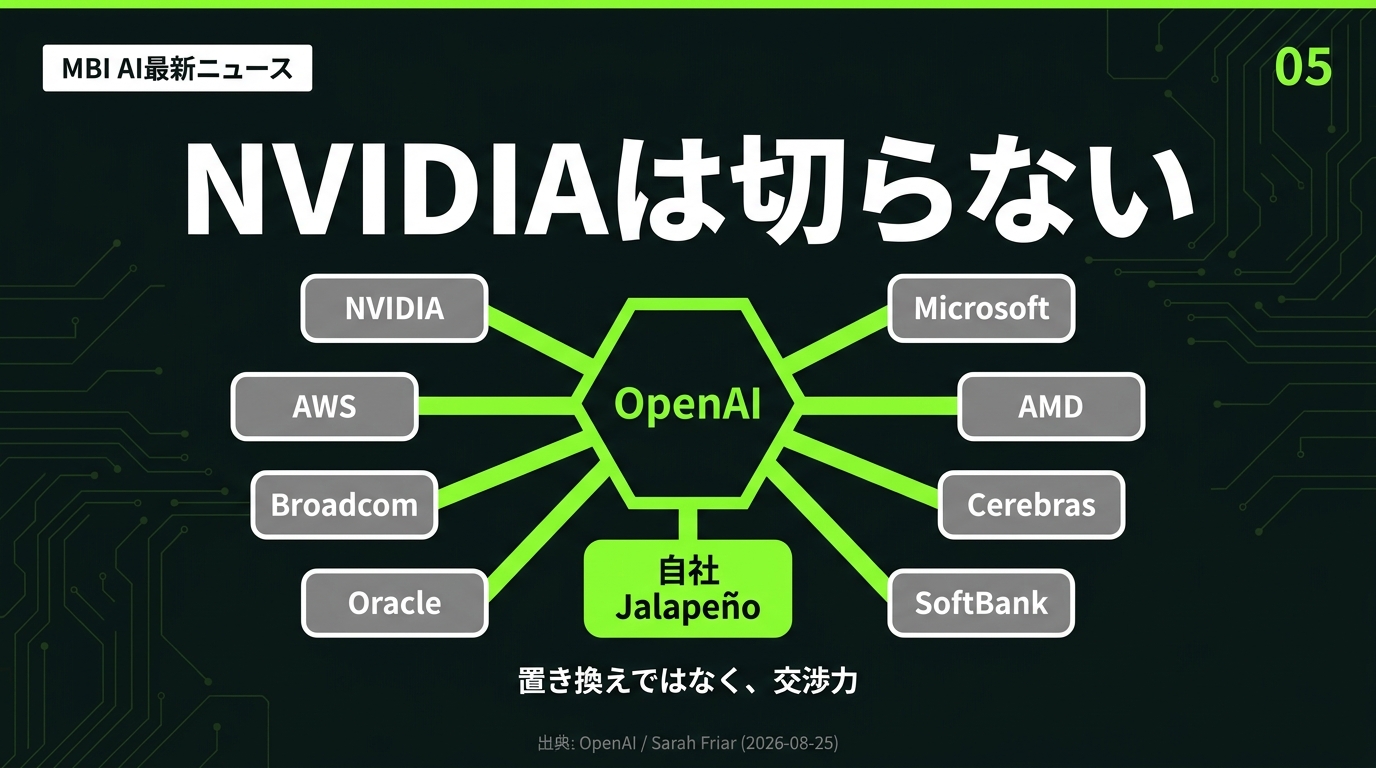
⑤ それでもNVIDIAは切らない——「置き換え」ではなく「交渉力」
ここを読み違えると、投資判断を誤る。OpenAIは記事の末尾で明確に書いている。「AIへの需要を満たすには、あらゆる供給源からのより多くの計算資源が必要になる。私たちは訓練・推論の両方で、NVIDIAおよび他のパートナーのアクセラレータを引き続き幅広く展開していく」。
CFOのSarah Friarの記事はさらに率直だ。OpenAIの調達ポートフォリオとして挙がっているのは、Microsoft、NVIDIA、AWS、AMD、Broadcom、Cerebras、CoreWeave、Oracle、SB Energy、SoftBank。そのうえで、こう書く——「提供事業者、ハードウェア、展開モデルにわたって信頼できる選択肢を維持することで、需要を最も性能対価格の強いところへ振り向け、市況が変わっても価格規律を保てる」。
これは「自社チップでNVIDIAを置き換える」宣言ではない。「自前の選択肢を持つことで、価格交渉のテーブルに座り直す」宣言である。Googleが長年TPUで実践してきたことを、OpenAIも手に入れつつある、という話だ。
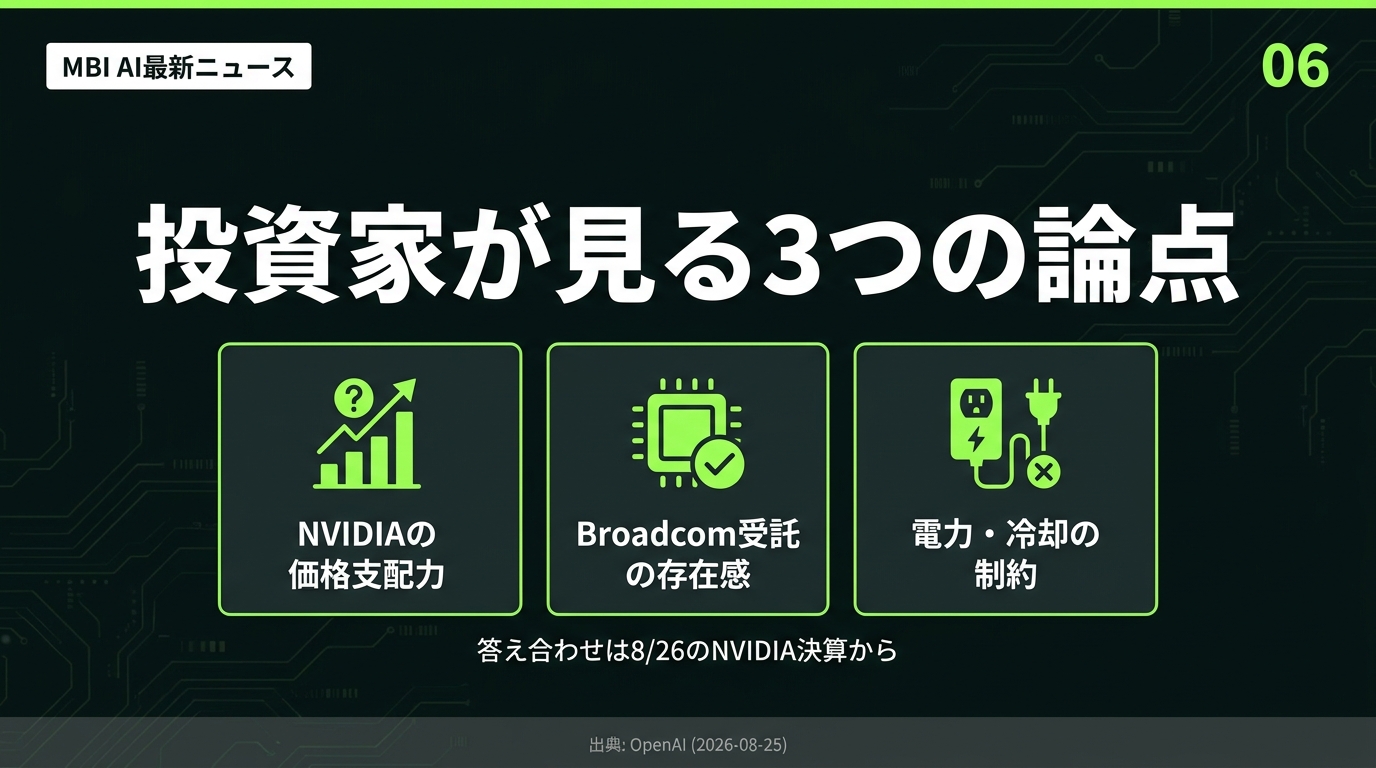
⑥ 投資への影響——8月26日の決算が最初の答え合わせ
投資の観点で押さえるべき論点は3つある。
1. NVIDIAの価格支配力。今回の発表そのものはNVIDIAの売上を1ドルも減らさない。Jalapeñoは自社インフラ向けで外販されず、OpenAI自身がNVIDIA製品の継続採用を明言している。焦点は粗利率の持続性のほうだ。主要顧客が全員「自前の代替案」を持つ世界では、値付けの自由度は徐々に削られる。8月26日の決算では、売上の伸びよりもガイダンスとマージンのトーンを見るべきだろう。
2. カスタムASIC受託の存在感。Jalapeñoの共同開発パートナーはBroadcomである。Google TPU、Meta MTIA、そしてOpenAI Jalapeño——「フロンティアラボは自社チップを持つ」が既定路線化するほど、受託設計の需要は積み上がる。汎用GPUと受託ASICでは、成長の質もマージン構造も異なる。
3. 電力がボトルネックであるという確認。1kWあたりで測るという方針表明は、業界が「電力が足りない」前提で動いていることの傍証だ。発電・送電・冷却まわりは、AI相場のなかで最も物理的で、最も置き換えが効かない部分である。
※本稿は投資助言ではない。個別銘柄の判断は各自の責任で行っていただきたい。
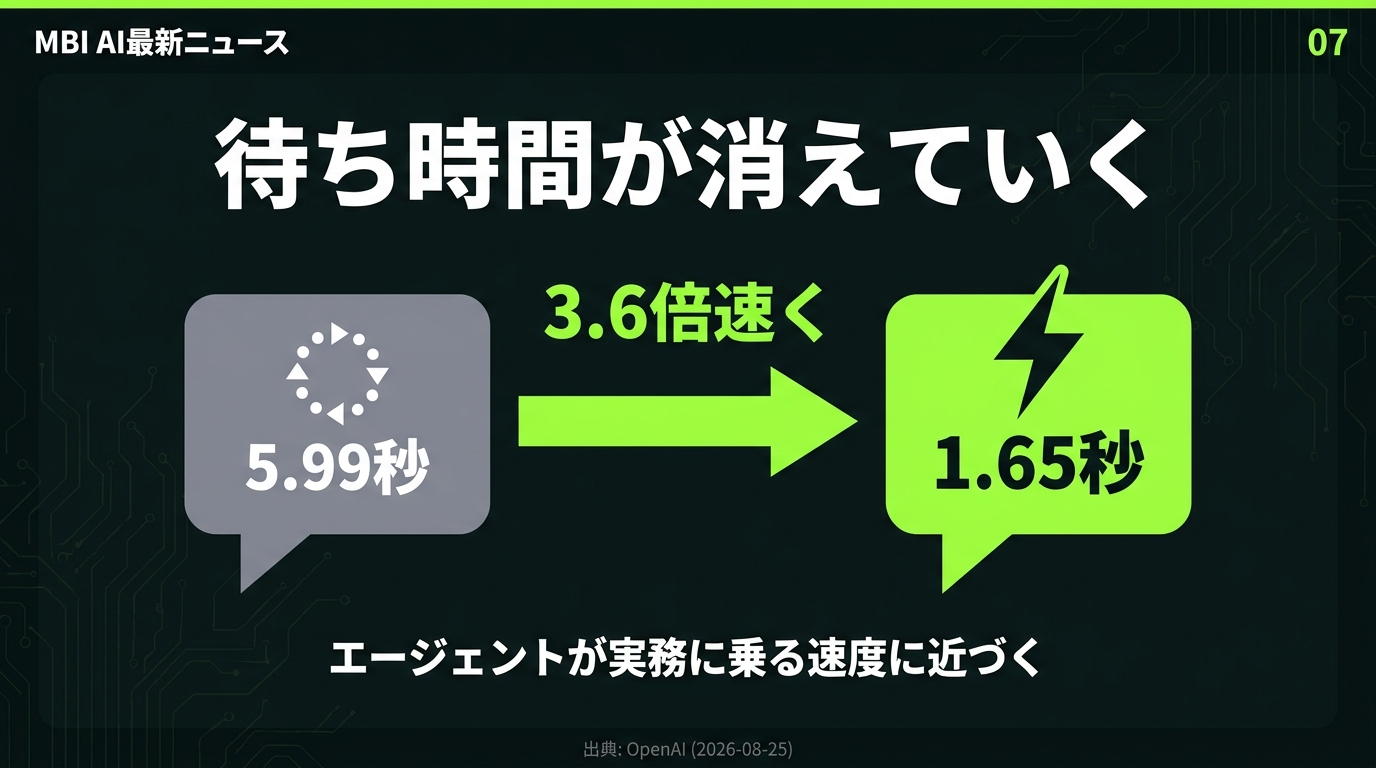
⑦ 生活への影響——「待ち時間」が静かに消えていく
ふだんAIを使う側から見ると、今回いちばん効いてくるのは倍率ではなく秒数だ。DeepSeek R1でのエンドツーエンド遅延は5.99秒から1.65秒へ。体感で言えば「聞いてから、コーヒーカップを置く前に返ってくる」水準である。
この差が効くのは、単発の質問よりエージェントのほうだ。何十回もモデルを往復するタスク——たとえば「請求書を全部読んで、条件が変わっているものだけ抜き出して、担当者にドラフトを書く」といった仕事では、1ステップあたりの遅延が積み上がる。OpenAIも「エージェントは多くのステップを順番に処理するため、遅延がタスク全体で複合する」と明記している。
そしてFriarの記事が持ち出すのがジェヴォンズのパラドックスだ。効率が上がると消費は減るのではなく増える。安く速くなったAIは、これまで「わざわざAIを使うほどでもない」とされていた仕事——全顧客への個別分析、全契約書のレビュー、毎朝の財務シナリオ再計算——に降りてくる。価格が下がって最初に変わるのは「使い方」ではなく「使う対象の範囲」である。
⑧ これから見るべき3点
① 年内の実配備が本当に始まるか。 OpenAIは「2026年内にOpenAIの計算基盤へJalapeñoの展開を開始する」としている。同時に「量産品質の確認、ソフトウェアの成熟、大規模運用の準備、より多くのモデルでの性能検証を継続中」とも書いており、まだ量産立ち上げの途中だ。年内という表現がQ4後半にずれ込むかどうかは、実際の効果が2027年にどれだけ乗るかを左右する。
② 第三者による再現検証が出るか。 今回の数値はすべてOpenAI自身の公表値である。InferenceXはSemiAnalysisの公開ベンチマークなので、第三者が同条件で追試する余地はある。ここで数字が概ね追認されれば、話の重みは一段変わる。
③ API価格にいつ反映されるか。 効率改善が値下げになるのか、粗利改善として留保されるのかは、経営判断である。Friarは「有用な仕事と収益が、提供コストより速く伸びる=オペレーティングレバレッジが効く」と書いており、全額を値下げに回すとは言っていない。実務者にとっての答え合わせは、次の価格改定のときに来る。
まとめ
OpenAIが2026年8月25日に公開したJalapeñoの初回実測は、公開ベンチマークInferenceX上で、GPT-OSS 120B・DeepSeek R1 670B・Kimi K2.5 1Tの3モデルすべてにおいて、NVIDIA GB200/GB300を電力あたり性能で1.5〜1.9倍、エンドツーエンド遅延で1.7〜3.6倍上回った。設計からテープアウトまで9か月、AIがチップを設計し、AIがそのチップ向けカーネルを人間より1.5〜1.8倍速く書いた。
ただし、これは「NVIDIA外し」の話ではない。OpenAI自身がNVIDIA製品の継続採用を明言し、CFOは10社規模の調達ポートフォリオを維持する理由を「価格規律」と説明している。動いたのは市場シェアではなく交渉のテーブルの形だ。
私たち使う側にとっての意味は単純である。AI推論の単価は、まだ下がる余地がある。そして「遅すぎて実務に乗らない」という理由でエージェント導入を見送ってきた領域は、ハードウェア側から先に制約が外れつつある。年内の実配備、第三者検証、そして次の価格改定——この3つが、今回の数字が本物かどうかを教えてくれる。
出典・参考情報
- OpenAI「Jalapeño's first results show industry-leading speed and efficiency in AI inference」2026年8月25日 — https://openai.com/index/jalapeno-first-results/
- OpenAI / Sarah Friar「The full stack behind abundant intelligence」2026年8月25日 — https://openai.com/index/the-full-stack-behind-abundant-intelligence/
- OpenAI News(発表一覧) — https://openai.com/news/
- ベンチマーク:InferenceX(SemiAnalysis)/Artificial Analysis Coding Agent Index
本記事の数値はすべてOpenAIの公表値に基づきます。第三者による再現検証は本稿時点で未公表です。本記事は情報提供を目的としたものであり、投資助言ではありません。